Analyse
Query routing, ou comment faire baisser durablement sa facture de tokens sans changer de dépendance
20 milliards de tokens en six jours. La réponse à l'explosion des coûts ne passe pas par moins d'IA mais par une IA mieux distribuée, le bon modèle pour la bonne tâche. Découpage du travail en issues, Claude Code avec DeepSeek, Paperclip multi-modèles, Edgee et RTK, modèles de décision, point d'étape sur une expérimentation en cours chez LINAGORA.
20 milliards de tokens en six jours
La semaine dernière, en moins de six jours, j’ai consommé 20 milliards de tokens pour livrer en parallèle trois modules distincts de notre plateforme twake.ai, dont Twake Space, sur lequel je reviendrai très prochainement ici. Au prix catalogue de l’API Opus 5.5 (4 dollars le million de tokens en entrée, 20 en sortie, 0,20 en lecture de cache), et en supposant qu’environ 90 % de ces tokens sont des relectures de cache comme c’est typique d’un agent de code, la facture tourne autour de 15 000 à 20 000 dollars. Soit près de 3 000 dollars par jour, ou l’équivalent d’un million de dollars par an à ce rythme, pour un seul utilisateur.
Je ne suis pas un cas isolé. Une grande banque américaine dépenserait déjà un million de dollars par semaine en tokens, et chez JPMorgan, le responsable data reconnaît que certains collaborateurs dépensent plus en tokens qu’ils ne gagnent. Côté public, le sujet est remonté jusqu’au gouvernement : cette semaine, le ministre David Amiel cherche à freiner les dépenses des agents de l’État liées à l’IA. Il avait déjà demandé fin août aux ministères de renégocier leurs contrats numériques, alors que les dépenses numériques des seuls ministères sont passées de 339 à plus de 720 millions d’euros depuis 2019.
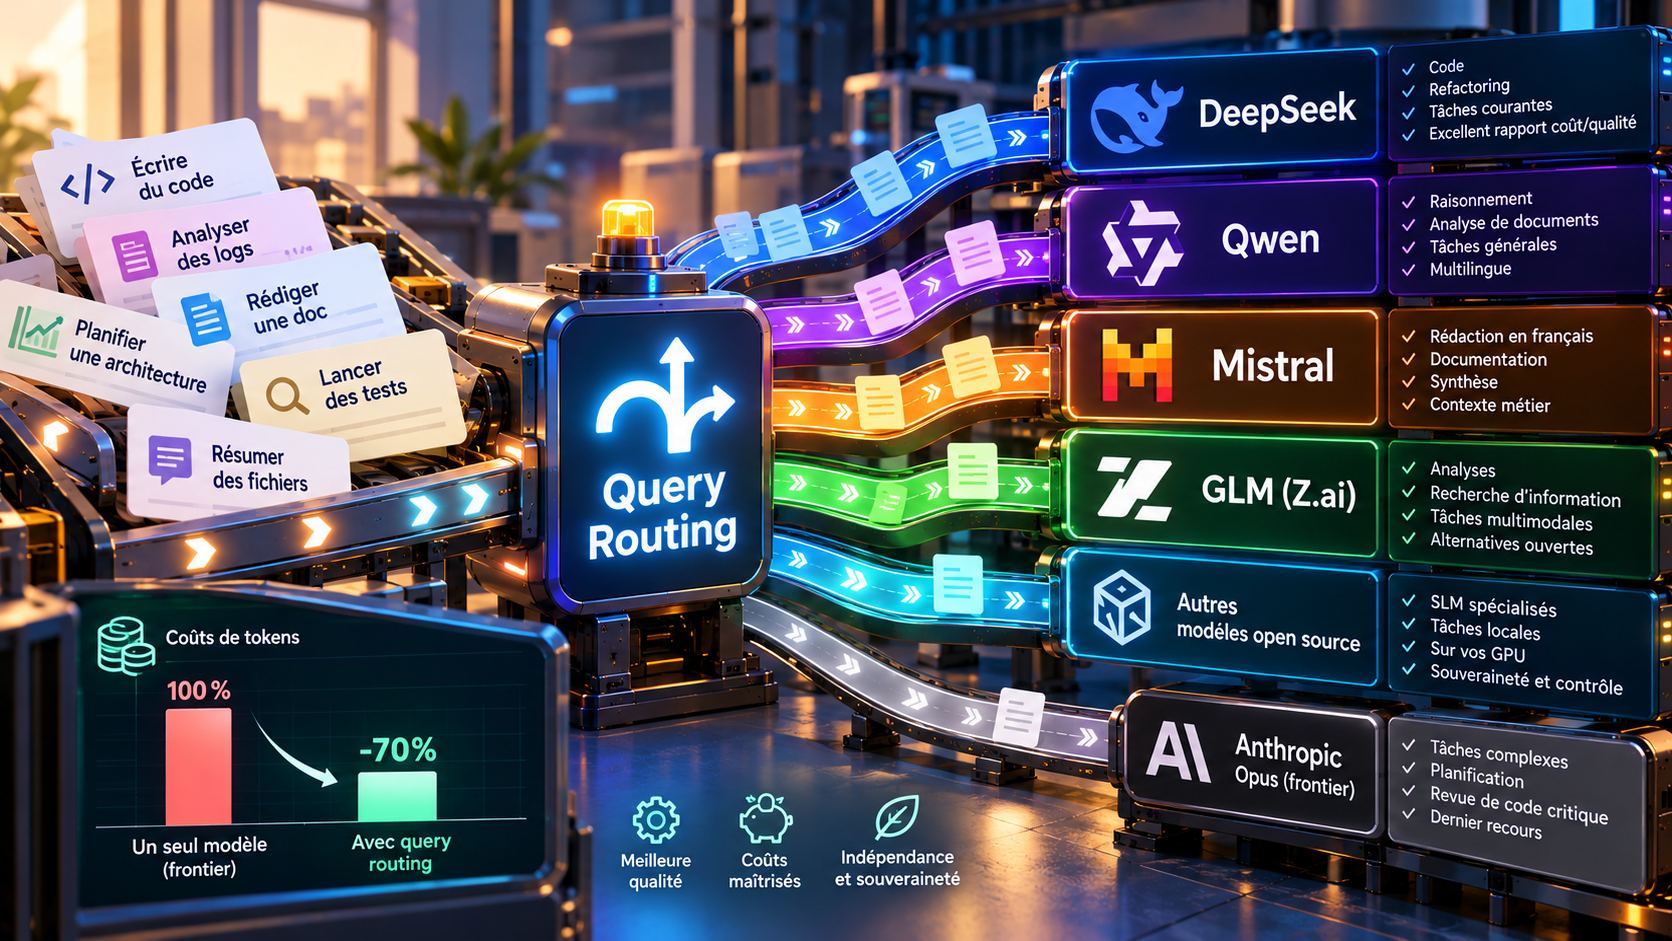
Les volumes explosent, les coûts suivent, et l’accès aux tokens ne fera qu’augmenter. Tout le monde se pose donc la même question : comment optimiser ? La réponse ne passe pas par moins d’IA, mais par une IA mieux distribuée. La bonne question n’est pas “quel modèle ?” mais “quel modèle pour quelle tâche ?”. C’est exactement ce qu’on appelle le query routing.
Depuis plusieurs semaines, j’expérimente différentes manières de le mettre en œuvre. Cet article est un point d’étape sur cette expérimentation en cours, pas un retour d’expérience définitif.
 Ce n’est pas une bidouille de bricoleur. Anthropic le pratique et l’assume ouvertement. Dans Claude Code, l’alias
opusplan utilise Opus en mode plan pour l’architecture et le raisonnement, puis bascule automatiquement sur Sonnet pour écrire le code (documentation Claude Code). Les tâches de fond passent par le modèle “haiku”, configurable via ANTHROPIC_DEFAULT_HAIKU_MODEL. Chaque sous-agent peut déclarer son propre modèle, et la documentation recommande explicitement de redéfinir l’agent d’exploration en model: haiku pour économiser (sous-agents).
En avril 2026, Anthropic est allé plus loin avec l’advisor strategy : un petit modèle exécute la tâche de bout en bout et consulte Opus seulement quand il bloque. Les chiffres publiés parlent d’eux-mêmes. Sonnet conseillé par Opus gagne 2,7 points sur SWE-bench Multilingual tout en coûtant 11,9 % de moins par tâche. Haiku conseillé par Opus passe de 19,7 % à 41,2 % sur BrowseComp, pour 85 % de moins que Sonnet seul.
Le message est clair : même le fournisseur du meilleur modèle de code considère qu’utiliser son modèle le plus cher pour tout est un gaspillage. Si Anthropic route ses propres requêtes entre ses modèles, rien ne nous oblige à ne router qu’entre les siens. Et c’est là que se joue l’enjeu : optimiser ses coûts sans s’enfermer dans une nouvelle dépendance à Anthropic.
Pourquoi c’est la clé d’une alternative à Claude Code
Une offre crédible face à Claude Code ne se joue pas sur un seul modèle, elle se joue sur deux briques : des modèles ouverts spécialisés (SLM ou modèles open weights de taille moyenne) et un harnais de développement qui sait les orchestrer. Aucun modèle ouvert ne rivalise aujourd’hui avec le meilleur frontier sur toutes les tâches. Mais une grande partie du travail d’un agent de code n’a rien de frontier : lire des fichiers, lancer des tests, résumer des logs, rédiger de la documentation, appliquer un refactoring déjà planifié.
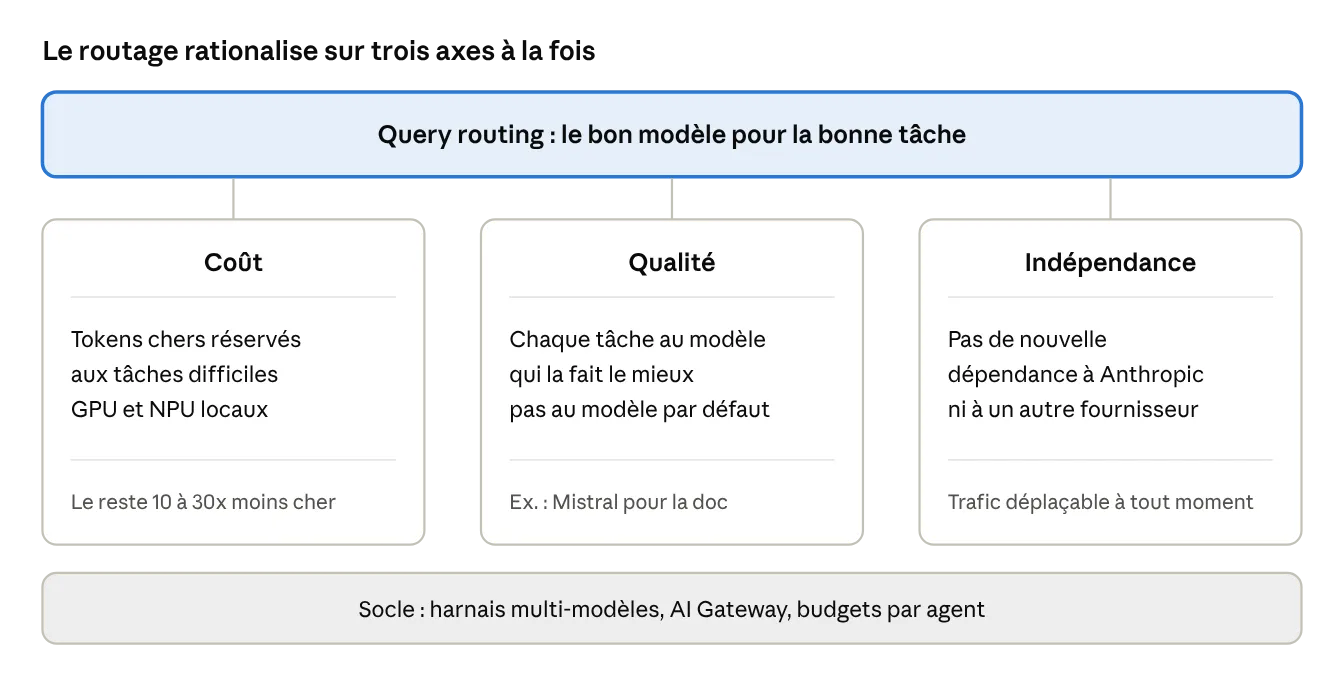
Le routage permet de tirer parti de cette réalité sur trois axes :
- Coût : on réserve les tokens chers aux tâches qui les justifient, et on fait tourner le reste sur des modèles dix à trente fois moins chers, voire sur ses propres GPU.
- Qualité : chaque tâche va au modèle qui la fait le mieux, pas au modèle par défaut. Mistral écrit mieux en français que la plupart des modèles de code, par exemple.
- Indépendance : après des années de dépendance aux grands éditeurs de logiciels et de cloud, il serait absurde d’en recréer une nouvelle envers un seul fournisseur de modèles, avec ses prix, ses quotas et sa feuille de route. Un harnais multi-modèles garde la main : si un fournisseur augmente ses tarifs ou change ses conditions, on déplace le trafic.
C’est dans cet esprit que nous expérimentons plusieurs configurations chez LINAGORA. Voici où nous en sommes.
Option 0 : optimiser le flux dans Claude Code, avant même de changer de modèle
 Avant de toucher au moteur, il existe un levier que l’on sous-estime : la manière de conduire le travail dans Claude Code. Souvenez-vous des 90 % de relectures de cache. À chaque tour, l’agent relit tout son contexte. Une longue session qui enchaîne dix tâches finit donc par traîner l’historique des neuf premières dans chaque appel de la dixième, et la facture croît bien plus vite que le travail utile. La compaction limite les dégâts, mais elle consomme elle-même des tokens et perd une partie du fil.
La parade consiste à structurer le travail comme le ferait une équipe :
- Une epic décrit l’objectif, l’architecture visée et le découpage, dans une issue GitHub (ou GitLab).
- Chaque tâche devient une issue autonome, documentée pour être exécutable sans le reste de la conversation : contexte, fichiers concernés, critères d’acceptation, tests attendus.
- Un modèle orchestrateur pilote l’epic sans écrire de code. Pour chaque issue, il démarre une session neuve, qui ne charge que l’issue et les fichiers utiles, livre une pull request et rend un résumé court.
- L’orchestrateur ne conserve que ces résumés, jamais le détail des échanges. Son propre contexte reste léger du début à la fin de l’epic.
Ce que j’en retiens à ce stade :
- C’est le gain le plus simple à obtenir : aucun changement de modèle, aucune nouvelle infrastructure, seulement de la discipline dans le découpage.
- La qualité y gagne aussi : un agent qui démarre avec un contexte propre et une consigne précise s’égare moins qu’un agent qui porte des heures d’historique.
- C’est la condition du routage : une tâche bien délimitée, décrite dans une issue, devient une unité que l’on peut confier à n’importe quel modèle. Les options suivantes reposent toutes sur ce découpage.
Option 1 : garder le harnais Claude Code, changer le moteur
 Première piste pour changer de modèle, la plus simple à mettre en place : conserver Claude Code comme harnais, mais faire tourner la session principale sur DeepSeek ou Qwen, et ne déléguer au modèle frontier d’Anthropic que certaines tâches précises (planification d’architecture, revue de code critique, débogage qui tourne en rond).
Techniquement, c’est devenu trivial. DeepSeek expose une API compatible Anthropic : quelques variables d’environnement (ANTHROPIC_BASE_URL, ANTHROPIC_DEFAULT_SONNET_MODEL, ANTHROPIC_DEFAULT_HAIKU_MODEL, CLAUDE_CODE_SUBAGENT_MODEL) et Claude Code parle à DeepSeek sans savoir qu’il a changé de cerveau. Pour mélanger plusieurs fournisseurs, on intercale une passerelle de type LiteLLM qui route selon le nom du modèle demandé : les slots “sonnet” et “haiku” partent vers DeepSeek ou un Qwen auto-hébergé, le slot “opus” ou un sous-agent dédié part vers le vrai Opus.
Pour rendre cette délégation propre et reproductible, nous avons publié claude-delegate, un plugin Claude Code open source (AGPL v3). Le développeur travaille dans une session “worker” sur DeepSeek, servi par notre AI Gateway. Quand il veut une revue exigeante, une commande comme /delegate:hostile-review ou /delegate:pr-review lance une session séparée sur Opus, en lecture seule (lecture, recherche, rien d’autre : ni shell, ni web, ni écriture), qui ignore les hooks et serveurs MCP du projet. Le rapport revient au worker DeepSeek qui trie les remarques, et rien n’est modifié sans validation humaine. Chaque revue est bornée (30 tours maximum, plafond indicatif de 5 dollars), et /delegate:handoff permet de rédiger un brief de spécification pour une session Anthropic quand la tâche le justifie vraiment. Le frontier devient un relecteur qu’on convoque, pas un moteur qui tourne en permanence.
Ce que j’en retiens à ce stade :
- Ce qui marche : le harnais reste excellent (outils, hooks, sous-agents, compaction), la bascule est instantanée pour les développeurs, et les tâches courantes passent très bien sur DeepSeek et Qwen.
- Ce qui coince : les prompts système et les descriptions d’outils de Claude Code sont optimisés pour Claude. Les autres modèles s’en sortent, mais avec plus d’appels d’outils ratés et de boucles inutiles, ce qui mange une partie des économies.
- Le vrai plafond : la délégation reste manuelle ou statique. On choisit le modèle par slot ou par sous-agent, pas en fonction de la difficulté réelle de la tâche. Et on reste dépendant d’un harnais propriétaire dont la feuille de route ne nous appartient pas.
C’est une bonne solution de transition, pas une stratégie.
Option 2 : Paperclip auto-hébergé, une équipe d’agents multi-modèles
 Deuxième piste, celle qui donne aujourd’hui les meilleurs résultats : Paperclip, un orchestrateur open source (licence MIT, plus de 100 000 étoiles sur GitHub) qui se présente comme un système d’exploitation pour équipes d’agents. On n’y pilote plus un assistant, on y organise une équipe : un organigramme avec des rôles et des lignes de reporting, des objectifs, des tickets traçables, des “heartbeats” qui réveillent les agents selon un planning, un budget mensuel par agent et des contrôles de gouvernance pour valider, mettre en pause ou réorienter (documentation). Le tout s’auto-héberge sur un poste, dans Docker ou sur un serveur.
Le projet a son site, paperclip.ing, qui montre bien la philosophie : on ne lance pas un agent, on monte une entreprise d’agents, avec un tableau de bord qui ressemble davantage à un outil de pilotage d’équipe qu’à un terminal.
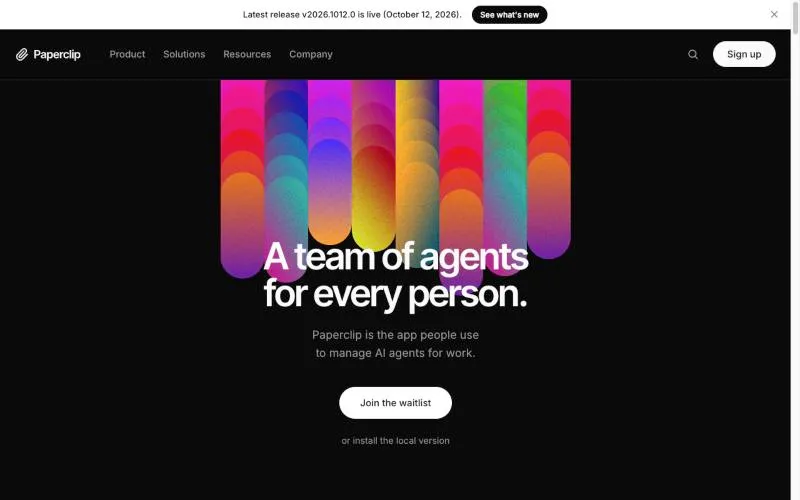
C’est cette notion de rôle qui change tout pour le routage. Au lieu de router requête par requête, on route par fonction : chaque agent de l’organigramme a son modèle, choisi pour ce qu’il fait le mieux. Notre répartition actuelle :
| Rôle dans l’équipe | Modèle | Pourquoi |
|---|---|---|
| Lead technique, planification, découpage en tickets | GLM 5.3 | Très bon raisonnement agentique et tenue des tâches longues |
| Développement et tests | Qwen | Excellent rapport qualité/coût en code, auto-hébergeable |
| Revue de code et débogage | DeepSeek | Raisonnement solide pour un coût très bas |
| Revue de sécurité | GLM 5.3 | Raisonnement long et rigueur d’analyse, pour traquer les failles et les dépendances à risque |
| Documentation, notes de version, README | Mistral | Qualité rédactionnelle, notamment en français, et modèle européen |
Ce que j’en retiens à ce stade :
- Le budget par agent est le meilleur outil d’optimisation des tokens qu’on ait trouvé. Un agent qui dérive se voit immédiatement, et on peut le couper sans arrêter toute la chaîne.
- Les capacités locales deviennent utiles. Un agent peut s’appuyer sur un modèle servi par le GPU d’un poste de travail ou le NPU d’un portable pour les traitements les moins complexes (lecture de fichiers, résumés de logs, reformulations). Ces tokens-là ne coûtent plus rien à la marge et ne quittent pas la machine.
- La spécialisation compense la taille. Quatre modèles ouverts bien placés font mieux qu’un seul modèle ouvert généraliste, et se rapprochent d’un frontier sur les tâches de développement courantes.
- La traçabilité est native : tickets, journal d’audit, validation humaine. C’est exactement ce que demandent nos clients publics quand on parle d’agents en production.
- Les limites : la mise en place demande un vrai travail de conception de l’organigramme et des prompts de rôle, et la documentation d’installation reste légère. Ce n’est pas un outil “clé en main” pour un développeur seul.
Rien n’empêche d’ajouter un agent “expert” adossé à un modèle frontier, sollicité rarement et avec un budget plafonné. On retrouve alors l’advisor strategy d’Anthropic, mais dans une architecture qu’on maîtrise.
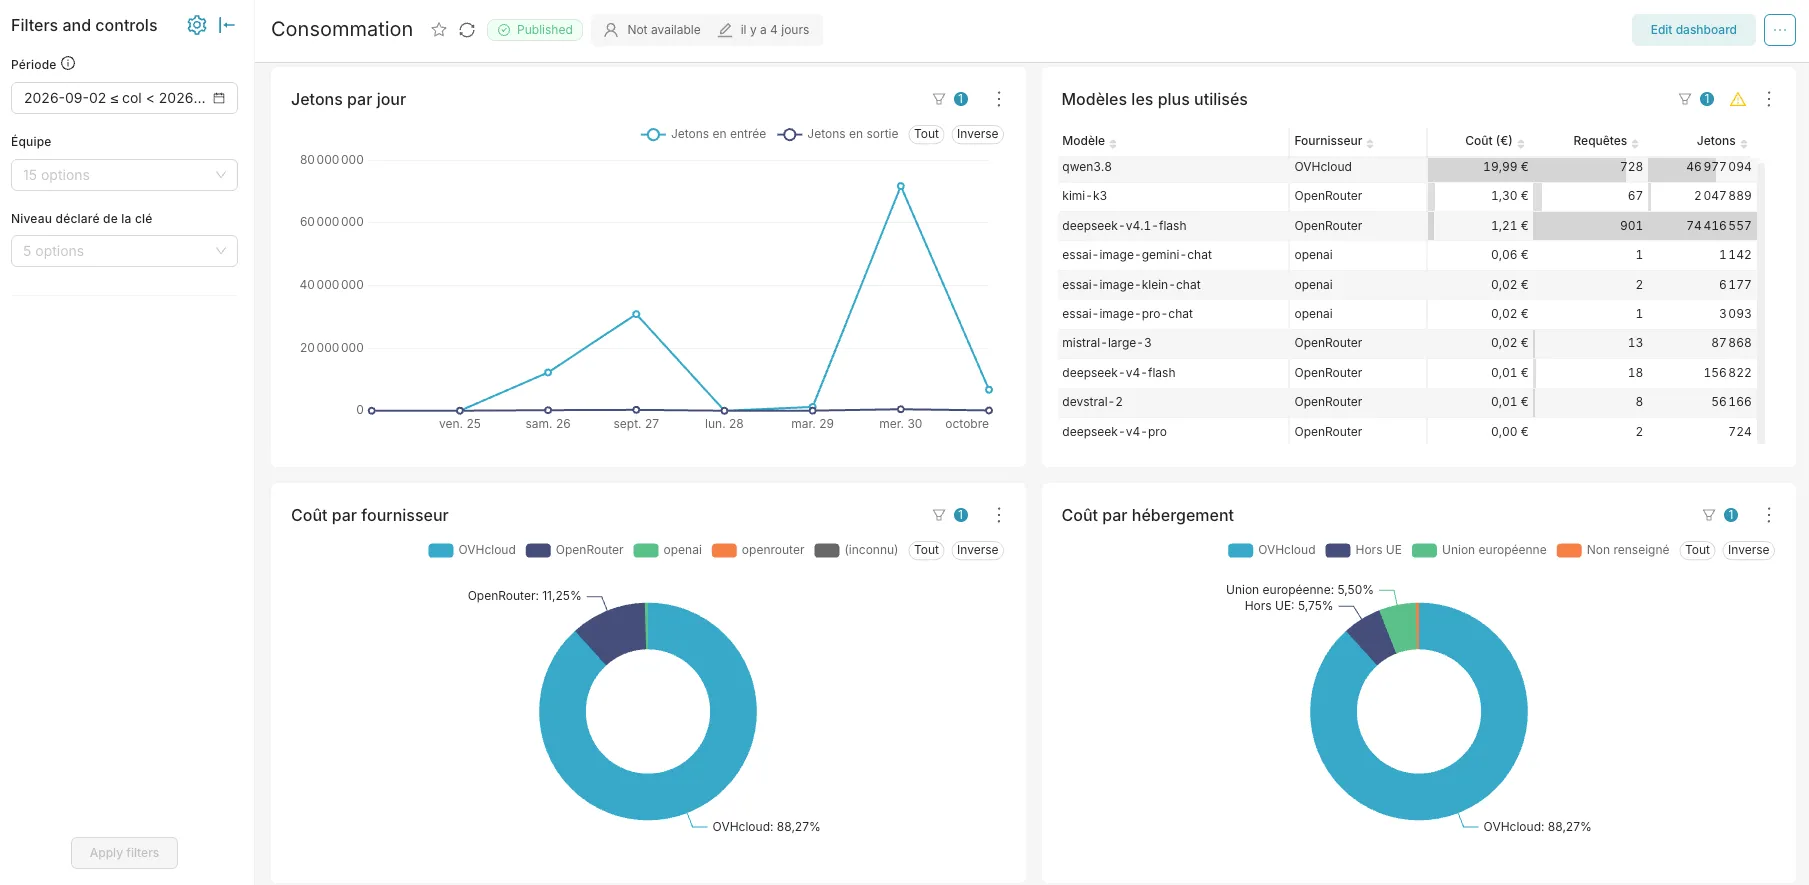
Cette option est certainement notre cible. C’est d’ailleurs elle qui a justifié la création de notre propre AI Gateway, publiée en open source sous licence AGPL v3. Elle expose un point d’accès unique compatible OpenAI pour toute l’entreprise, s’appuie sur LiteLLM et applique deux règles que Paperclip ne gère pas seul. La première est un budget et une durée de validité par clé, donc par agent ou par équipe. La seconde est une règle de confidentialité par modèle : les données sensibles ne partent que vers des modèles hébergés en France, chez OVHcloud, sans repli possible ailleurs. Paperclip décide quel agent travaille, l’AI Gateway décide où partent ses tokens et combien il peut en dépenser, avec des tableaux de bord de coûts par équipe et par modèle.
Option 3 : deux initiatives françaises à suivre de près
Le routage ne se limite pas au choix du modèle. On peut aussi agir sur ce qu’on envoie au modèle. Deux projets français attaquent le problème sous cet angle, et je les suis avec attention.
 Edgee, cofondé par Sacha Morard, se positionne comme une passerelle entre les agents de code et les fournisseurs de modèles. Il combine deux leviers : la compression des tokens (résultats d’outils allégés avant inférence, sans toucher au code) et le routage (budgets par développeur, équipe ou organisation, avec bascule vers des modèles open weights quand le budget est atteint, et repli automatique si un fournisseur tombe). L’outil s’utilise sans modifier ses habitudes, par exemple avec
edgee launch claude, et permet de changer de modèle en cours de session Claude Code parmi plus de 200, Mistral compris. Edgee annonce jusqu’à 70 % d’économies en combinant routage et compression (page produit). Je ne l’ai pas encore testé : le chiffre reste donc à vérifier sur nos propres usages, notamment l’effet sur le cache quand on change de modèle en pleine conversation.
 RTK, porté par deux fondateurs français basés à Lille, prend le problème par l’autre bout : un proxy CLI en Rust, sous licence Apache 2.0, qui filtre la sortie des commandes shell avant que l’agent ne la lise.
git status, les tests, les linters, les gestionnaires de paquets : plus de 100 commandes sont compressées (bruit supprimé, éléments regroupés, logs répétitifs fusionnés), avec des réductions annoncées de 60 à 90 % sur la sortie bash. Le projet a l’honnêteté de préciser que ce n’est pas 90 % de moins sur la facture, puisque la sortie shell n’est qu’une partie des tokens consommés. Il s’intègre à 18 outils (Claude Code, Cursor, Gemini CLI…) et dépasse les 80 000 étoiles sur GitHub. Je vais le tester dans les prochains jours.
Les deux approches sont d’ailleurs complémentaires de Paperclip : RTK réduit le contexte à la source, Edgee optimise au niveau de la passerelle, Paperclip choisit le bon agent. Et il est réjouissant de voir la French Tech aussi présente sur cette couche d’optimisation.
L’approche Jev : un aiguilleur qui décide au lieu de générer
Reste une question : qui décide du routage ? Dans Paperclip comme dans Claude Code, le choix du modèle est aujourd’hui fixé par configuration. Pour aller plus loin, il faut une couche de décision capable de classer chaque tâche entrante et de l’envoyer au bon agent. Et demander à un LLM génératif de faire ce tri, c’est payer des tokens pour obtenir du texte qu’il faut ensuite parser.
C’est là qu’intervient une nouvelle famille de modèles : les modèles de décision. Jev, développé par TypeSafe et entré en accès anticipé mi-septembre, ne génère pas de texte. On lui donne un état (un ticket, un log, un JSON) et une liste de questions typées, il répond par un choix parmi les options fournies, un score ou un oui/non, accompagné d’une probabilité calibrée. Il ne peut pas inventer une option hors de la liste, ce qui en fait un excellent aiguilleur.
 L’alternative ouverte est arrivée il y a quelques jours : Decision 3.0, publié le 10 octobre par l’équipe vLLM Semantic Router. Ce sont six modèles sous licence Apache 2.0, de 0,6 à 26 milliards de paramètres, construits sur Qwen, qui reprennent le même contrat que Jev. Le plus gros, d3, revendique 64,1 sur le Jev Decision Index contre 60,1 pour Jev, et d3-nano répond en une vingtaine de millisecondes (détails). Chiffres auto-déclarés, à reproduire, mais la direction est la bonne.
Où placer cet aiguilleur : en amont de Paperclip
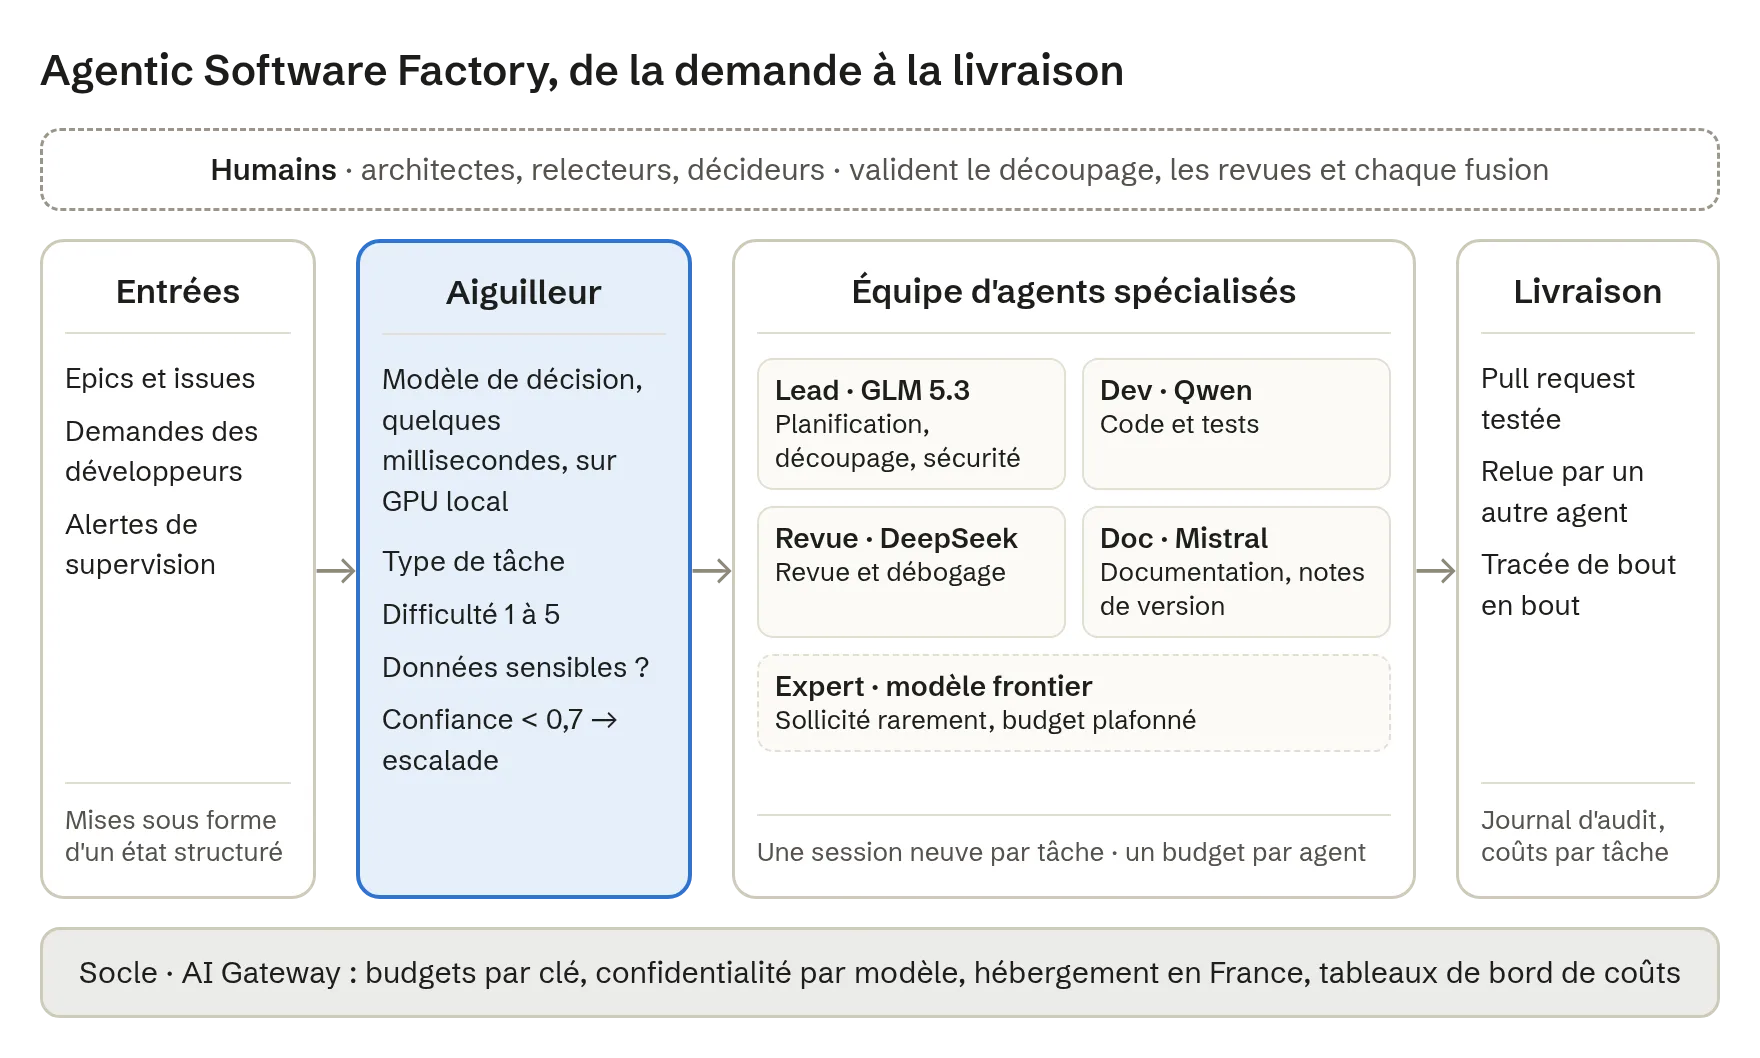
Aujourd’hui, dans notre configuration Paperclip, c’est l’agent lead (GLM 5.3) qui lit chaque ticket entrant et décide qui le traite. Cela fonctionne, mais c’est cher pour ce que c’est : un appel complet à un grand modèle, avec tout le contexte du ticket, plusieurs secondes de latence, et une réponse en texte libre qu’il faut interpréter. Surtout, on mobilise notre modèle le plus capable pour une tâche de tri.
L’idée est donc de sortir ce tri de Paperclip et de le placer juste avant, comme un aiguillage à l’entrée de la gare. Le ticket arrive déjà qualifié et affecté, et Paperclip n’a plus qu’à exécuter. Concrètement :
- Une tâche arrive : ticket GitLab, demande d’un développeur, alerte de supervision. Elle est mise sous forme d’un état structuré (titre, description, fichiers concernés, projet).
- Le modèle de décision répond à quatre questions typées, en un seul appel, chacune avec sa probabilité. Quel type de tâche (fonctionnalité, correctif, refactoring, documentation, revue) ? Quelle difficulté, sur une échelle de 1 à 5 ? Le contexte contient-il des données sensibles (oui/non) ? Faut-il une vision large de la base de code (oui/non) ?
- Des règles déterministes transforment ces réponses en affectation. Le type choisit l’agent : correctif vers Qwen, revue vers DeepSeek, documentation vers Mistral. Une difficulté élevée ou un besoin de vision large fait d’abord passer le ticket par le lead GLM 5.3 pour un découpage. Des données sensibles imposent un modèle local ou hébergé en France via l’AI Gateway, quoi qu’il arrive.
- La confiance sert de garde-fou. Si le modèle hésite (probabilité sous un seuil, par exemple 0,7) ou si la difficulté est maximale et les données non sensibles, le ticket est escaladé : vers le lead, voire vers l’agent expert adossé au frontier.
Ce déplacement change trois choses. D’abord le coût : la décision prend quelques millisecondes sur un modèle de moins d’un milliard de paramètres, qui tourne sans difficulté sur un GPU local, au lieu d’un appel à un grand modèle. Ensuite l’auditabilité : chaque affectation est justifiée par des réponses typées et des probabilités journalisées, pas par un raisonnement en prose. Enfin la maîtrise : faire évoluer la politique de routage revient à modifier une règle ou un seuil, pas à réécrire un prompt en espérant que le modèle suive. C’est, à mon sens, la brique qui manquait pour passer d’un routage statique, fixé par configuration, à un routage dynamique, décidé tâche par tâche.
Mon verdict à ce jour : Paperclip
À la question “comment faire aussi bien que Claude Code sans Claude Code ?”, ma réponse aujourd’hui est Paperclip. Non pas parce qu’il remplace un modèle frontier, il ne le fait pas, mais parce qu’il change la nature du problème : on ne cherche plus le meilleur modèle, on compose la meilleure équipe. GLM 5.3 pour planifier et auditer la sécurité, Qwen pour coder, DeepSeek pour relire, Mistral pour documenter, chacun avec son budget, ses tickets et sa traçabilité, le tout sur une infrastructure que nous maîtrisons.
L’option Claude Code avec DeepSeek ou Qwen reste la plus confortable pour démarrer, et les modèles d’Anthropic restent la référence pour les tâches les plus difficiles. Mais le routage n’est pas un compromis de pauvre. C’est la méthode qu’Anthropic applique à ses propres produits. En l’appliquant avec des modèles ouverts, un harnais open source, des optimiseurs comme RTK et Edgee, et demain une couche de décision comme Decision 3.0, on obtient quelque chose de rare : une alternative qui n’est pas seulement acceptable, mais efficiente, et qui nous évite de troquer une dépendance contre une autre.
Au fond, ce que nous construisons dépasse l’optimisation des tokens. Le routage, les budgets par agent, la gateway, l’aiguilleur en amont : ce sont les fondations d’un changement plus profond, le passage de la gestion d’une base de code classique, où des développeurs écrivent du code assistés par un outil, à une Agentic Software Factory. Dans cette usine logicielle, les tickets entrent, sont qualifiés, affectés à des agents spécialisés, exécutés, relus et tracés, et les humains y tiennent le rôle d’architectes, de relecteurs et de décideurs. Une telle usine ne peut pas reposer sur un seul fournisseur de modèles : elle doit pouvoir choisir, à chaque poste de travail, le bon outil au bon prix.
Mes premières observations montrent qu’on peut déjà facilement optimiser 30 à 40 % de la facture de tokens. Je reviendrai sur ces expérimentations dans quelques semaines, chiffres de consommation détaillés à l’appui.
Sources
- Claude Code, configuration des modèles
- Claude Code, sous-agents
- Anthropic, The advisor strategy (avril 2026)
- La Lettre, David Amiel cherche à freiner les dépenses des agents de l’État liées à l’IA (12 octobre 2026)
- Clubic, Avec l’IA, Bercy veut faire payer moins cher les prestations informatiques de l’État
- Evident, Time to pay the AI piper
- DeepSeek, intégration Claude Code
- LINAGORA claude-delegate
- LINAGORA AI Gateway
- Paperclip, site, GitHub et documentation
- Edgee et compression des tokens
- RTK sur GitHub
- Beam AI, Jev de TypeSafe
- MarkTechPost, Decision 3.0
- OrcaRouter, Decision 3.0 sur Hugging Face
Commentaires
Réponses imbriquées possibles. Vous commentez en tant qu'invité : choisissez un pseudo, et c'est tout. Modération a posteriori : tout est publié immédiatement, je peux retirer si besoin.