Annonce
AI Gateway, reprendre la maîtrise de l'IA en entreprise
Au DevDay 2026, OpenAI remet en cause le prix de l'IA, vitesse facturée, quotas qui se divisent, abonnements qui deviennent des monnaies. LINAGORA publie AI Gateway, une passerelle open source de gouvernance et de FinOps pour reprendre la maîtrise des usages de l'IA en entreprise, administration ou collectivité.
Le 29 septembre, OpenAI tenait sa journée développeurs annuelle, le DevDay 2026. On a beaucoup parlé des nouveaux modèles, GPT-6.1 Sol, Dots (un agent qui travaille en continu), les espaces partagés ChatGPT Space, Codex dans le cloud (Axios, les 5 annonces majeures). Les annonces les plus lourdes de conséquences pour les organisations portent pourtant sur la manière de payer l’IA.
En une journée, OpenAI a modifié son modèle économique sur plusieurs points :
- On paie désormais la vitesse. En plus du tarif standard, l’API propose un niveau Fast, environ deux fois plus rapide et facturé deux fois plus cher, et un niveau Ultrafast, jusqu’à six à huit fois plus rapide et facturé six fois plus cher. Un même jeton, produit par le même modèle, n’a donc plus un prix unique, ce prix dépend de l’urgence de la réponse (community.openai.com, annonces DevDay ; BenchLM, décryptage DevDay 2026).
- Les écarts de prix entre modèles se creusent. GPT-6.1 Sol est présenté comme proche de GPT-6 Astra, le modèle le plus puissant, sur le code et l’usage d’un ordinateur, pour un prix standard par jeton cinq fois plus bas. Choisir le bon modèle pour chaque tâche devient une décision budgétaire à part entière (community.openai.com ; BenchLM).
- Les forfaits deviennent des quotas qui bougent. OpenAI lance un forfait Pro à 500 $ par mois, qui donne 25 fois l’usage de Plus et l’accès à Ultrafast. Dans le même temps, ce que permet le forfait Pro à 200 $ est divisé par deux à compter du 30 octobre, on passe de 20 à 10 fois l’usage de Plus dans ChatGPT Work et Codex, et de 200 à 100 messages GPT-6 Pro par semaine. Les abonnés en cours conservent leurs limites jusqu’au 29 octobre, avec un crédit ponctuel en compensation (The Next Web, le nouveau plan à 500 $ ; Business Today). Pour un même prix, on reçoit donc deux fois moins.
- L’abonnement sert de monnaie dans d’autres outils. Avec « Sign in with ChatGPT », un utilisateur Plus ou Pro peut consommer son forfait dans seize outils partenaires. Côté entreprises, la nouvelle Marketplace permet d’affecter un engagement de dépense contracté auprès d’OpenAI à des logiciels partenaires (community.openai.com ; The Next Web).
- Une nouvelle catégorie de modèles apparaît. La Decisions API, en préversion limitée, confie à un petit modèle des choix étroits et répétitifs, avec des réponses définies à l’avance. Elle n’a pas encore de grille tarifaire publiée (community.openai.com ; BenchLM).
Ces annonces montrent que le prix de l’IA ne tient plus en un seul chiffre. Il dépend du modèle, de la vitesse demandée, du forfait, de crédits qui expirent, d’enveloppes reportées d’un produit à l’autre et de quotas que le fournisseur peut réduire d’un mois sur l’autre. Une organisation qui n’instrumente pas ses usages ne peut ni anticiper ces changements, ni comparer les offres, ni décider si un abonnement à 200 ou 500 $ reste justifié face à des appels d’API facturés à l’usage.
Ces évolutions rendent plus nécessaire que jamais de savoir ce que l’on consomme, qui le consomme, avec quel modèle et à quel prix, puis d’optimiser.
Les questions que pose le déploiement de l’IA
Qui utilise l’IA dans mon organisation ? Avec quels modèles, quels fournisseurs, quelles clés d’API, quels abonnements, et pour quel coût réel ?
Ces questions arrivent vite dès qu’une entreprise, une administration ou une collectivité commence à déployer l’IA. Elles ne relèvent pas seulement de la comptabilité, elles touchent aussi la sécurité, la gouvernance, la souveraineté, l’organisation du travail et la capacité à faire des choix technologiques éclairés.
Chez LINAGORA, nous y sommes confrontés nous-mêmes. Nos équipes utilisent différents services et abonnements, notamment autour de Claude Code. Nous consommons des modèles ouverts auprès de plusieurs fournisseurs d’API. Nous opérons aussi nos propres modèles sur nos serveurs GPU, notamment autour de Luciole.
Cette diversité est une force. Elle permet de choisir le bon modèle selon le cas d’usage, les performances attendues, le niveau de confidentialité nécessaire, les contraintes de souveraineté ou le budget disponible.
Elle soulève aussi des questions très concrètes :
- Qui a accès à quels services et à quels modèles ?
- Quelles applications, quels agents ou quelles automatisations utilisent quelles clés d’API ?
- Quel est le coût réel d’un usage, d’une équipe, d’un produit ou d’un client ?
- Comment rapprocher les dépenses d’API, d’abonnements et d’infrastructure GPU ?
- Comment éviter les clés partagées, les comptes isolés et les dépenses impossibles à attribuer ?
- Comment laisser les équipes expérimenter sans perdre la maîtrise des accès, des données et des budgets ?
- Comment orienter un utilisateur vers le modèle qui convient à son besoin, plutôt que de le laisser choisir au hasard dans une liste de plusieurs dizaines de modèles ?
- Comment faire cohabiter les modèles externes, les modèles open source hébergés par un fournisseur et nos propres modèles ?
Pour répondre à ces questions, nous publions aujourd’hui AI Gateway, notre outil open source de gouvernance technique et financière des usages de l’IA.
Le code source est disponible sur GitHub, sous licence AGPL-3.0, linagora/ai-gateway.
L’IA se déploie plus vite que sa gouvernance
Dans la plupart des organisations, l’IA n’arrive pas par un programme unique, centralisé et bien outillé. Elle commence par quelques expérimentations. Une équipe métier teste un assistant conversationnel. Des développeurs adoptent un outil de génération de code. Une application appelle un modèle par API. Un projet ouvre un compte chez un fournisseur, pendant qu’une équipe infrastructure met à disposition des modèles auto-hébergés.
Puis les usages se multiplient, et les dépenses avec eux.
Une facture d’IA est rarement simple à lire. Elle se répartit entre des abonnements individuels, plusieurs fournisseurs d’API, des coûts au jeton, des ressources GPU, de l’hébergement, du stockage, de l’observabilité et des équipes d’exploitation. Les annonces d’OpenAI y ajoutent des niveaux de vitesse, des crédits et des quotas mouvants. Sans point de passage commun, il devient difficile de savoir qui consomme quoi, de repérer les usages les plus coûteux ou de décider où optimiser.
Le risque ne se limite pas au dépassement de budget. Sans gouvernance, une organisation peut aussi envoyer des données trop sensibles à un modèle qui ne convient pas, utiliser un modèle coûteux pour une tâche simple, laisser se multiplier les solutions de contournement ou perdre toute traçabilité des usages.
L’IA ne peut pas devenir un service durable du système d’information si elle reste un assemblage de comptes, de clés secrètes, de tableaux de bord fournisseurs et de factures séparées. Il faut pouvoir la piloter.
Une passerelle pour piloter les usages
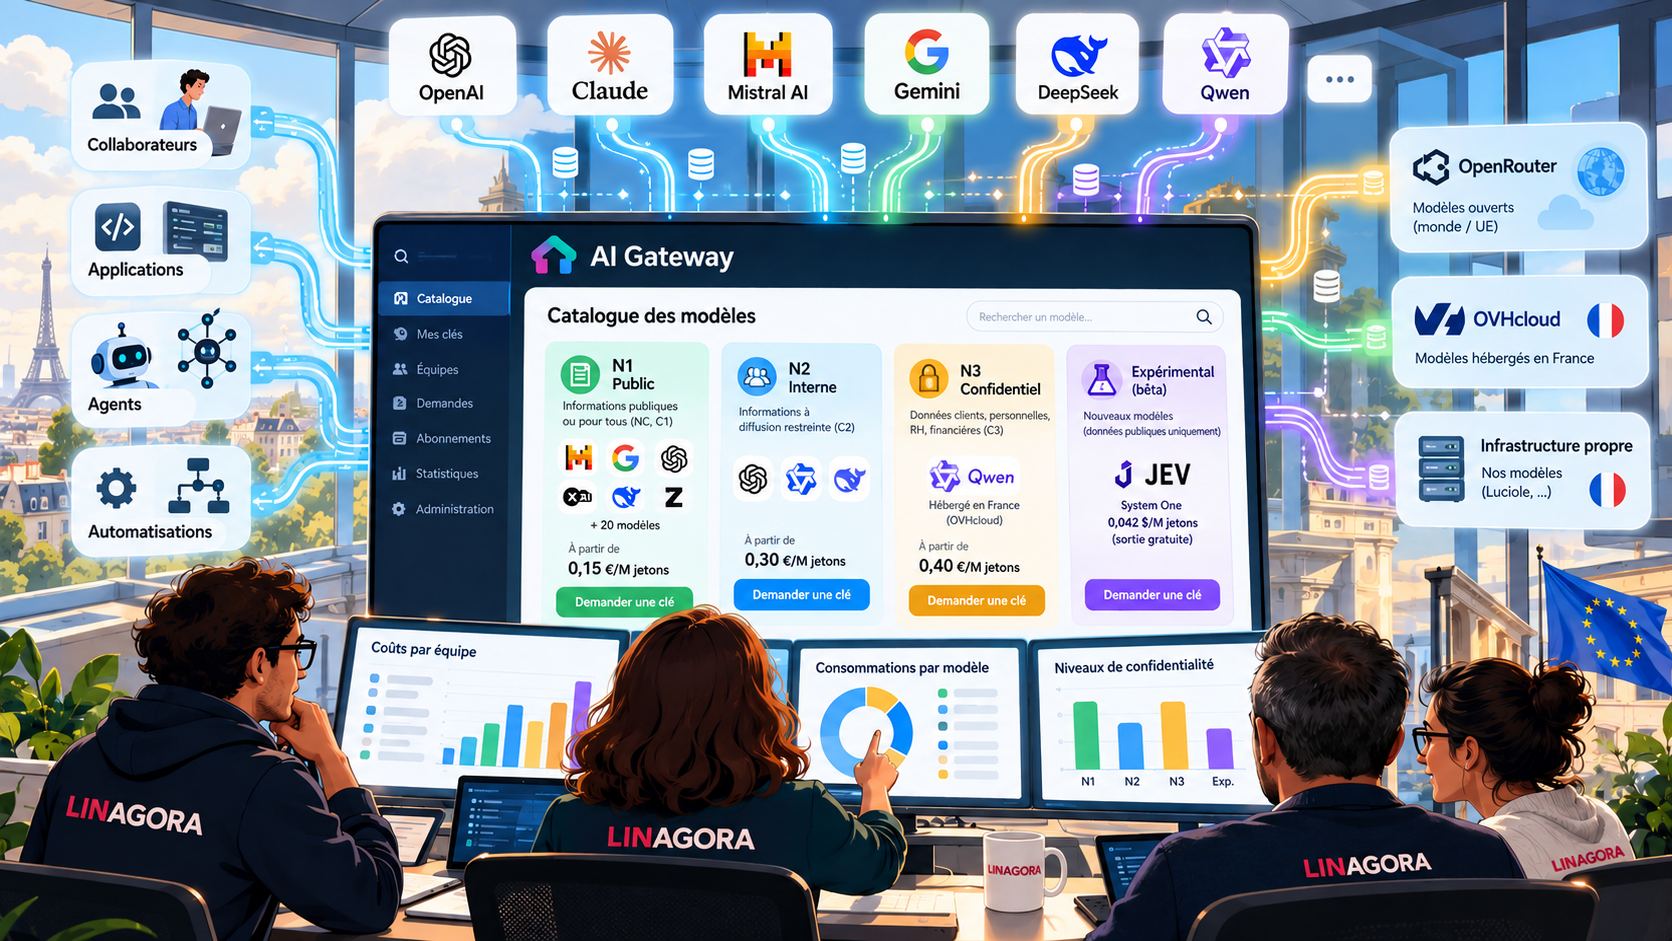
AI Gateway est une couche de gouvernance placée entre, d’un côté, les utilisateurs, les applications et les agents, et de l’autre, les modèles d’IA utilisés par l’organisation.
Le but n’est pas de freiner l’innovation. Il est de laisser les équipes utiliser l’IA en autonomie, tout en donnant à l’organisation la visibilité et les moyens de contrôle dont elle a besoin.
AI Gateway permet notamment de :
- centraliser l’accès à plusieurs modèles et fournisseurs derrière un seul point d’accès compatible avec l’API d’OpenAI, qu’ils soient appelés par API ou déployés en interne ;
- suivre les consommations et les rendre lisibles par les équipes techniques, produit, métier et financières ;
- organiser les utilisateurs, les équipes et leurs périmètres de responsabilité ;
- gérer les clés d’API des applications, des automatisations et des agents, chacune avec son budget et sa durée de validité ;
- poser des règles de gouvernance sans freiner l’expérimentation ;
- mener une démarche FinOps appliquée à l’IA, comprendre, attribuer, maîtriser et optimiser les dépenses ;
- aider chaque utilisateur à choisir le modèle, l’abonnement ou la clé qui correspond à son besoin et aux règles de l’organisation.
Cette approche compte particulièrement dans les environnements hybrides, où cohabitent des services d’IA dans le cloud, des modèles open source hébergés chez un fournisseur, des modèles spécialisés accessibles par API et des modèles déployés sur ses propres serveurs GPU.
Une passerelle de gouvernance ne doit pas imposer un choix unique. Elle doit rendre ces choix visibles, comparables et gouvernables.
Ce que fait AI Gateway
AI Gateway ne se contente pas de relayer des requêtes vers des modèles. Il apporte ce qu’il faut pour faire de l’IA un service intégré au système d’information, identité, accès, catalogue de modèles, équipes, circuits de validation, clés applicatives, traçabilité et suivi des consommations.
Un catalogue pour guider le choix du modèle
La gouvernance commence par le choix du modèle.
L’offre se diversifie très vite, et une longue liste de noms techniques ne suffit pas. Les utilisateurs ont besoin d’être guidés vers le modèle, le fournisseur, l’abonnement ou la clé qui correspond à leur besoin réel.
AI Gateway organise le catalogue selon plusieurs critères :
- le niveau de sensibilité des données traitées ;
- les contraintes de confidentialité, de souveraineté et d’hébergement ;
- la zone d’exécution de chaque modèle (Union européenne ou reste du monde) ;
- les cas d’usage autorisés ou recommandés ;
- les capacités recherchées, rédaction, raisonnement, code, documents, rapidité, images ;
- le prix par million de jetons ;
- le mode d’accès, abonnement individuel, clé d’API, service interne ou modèle déployé sur une infrastructure propre.
Le catalogue est la porte d’entrée de l’utilisateur. Plutôt que de laisser chacun se débrouiller seul face à une offre complexe, il l’oriente vers l’accès le plus approprié.
Un collaborateur qui travaille sur des documents internes à diffusion restreinte ne doit pas se voir proposer les mêmes modèles ni les mêmes fournisseurs qu’un collaborateur qui traite une information publique. Un développeur qui intègre un modèle dans une application n’a pas besoin du même accès qu’une personne qui veut préparer une synthèse.
Cette approche concilie trois objectifs souvent contradictoires, offrir un service simple, protéger les données de l’organisation et maîtriser les coûts.
Authentification unique et gestion des identités
Dans une organisation, personne ne devrait avoir à créer un compte de plus pour accéder à un service interne d’IA. AI Gateway s’appuie sur l’authentification unique (SSO) via OpenID Connect, chez LINAGORA, c’est LemonLDAP::NG qui la fournit.
La passerelle reprend ainsi les politiques de sécurité, le cycle de vie des comptes et l’annuaire de référence de l’organisation. On évite de créer une nouvelle population d’identifiants isolés, et l’IA devient un service gouverné du système d’information plutôt qu’une collection de comptes ouverts chez des fournisseurs.
Équipes et circuits de validation
La gouvernance ne peut pas se faire utilisateur par utilisateur. Une organisation est faite d’équipes produit, de directions métier, de projets, de filiales, de clients, de partenaires et de prestataires.
AI Gateway structure les usages autour de ces réalités. Chaque équipe a ses accès, son périmètre, son budget et ses responsables. Un responsable d’équipe valide les demandes de son équipe, jamais les siennes. Une alerte prévient quand le budget de l’équipe approche de sa limite. Une fois ce budget atteint, la passerelle refuse les clés de l’équipe jusqu’à la période suivante.
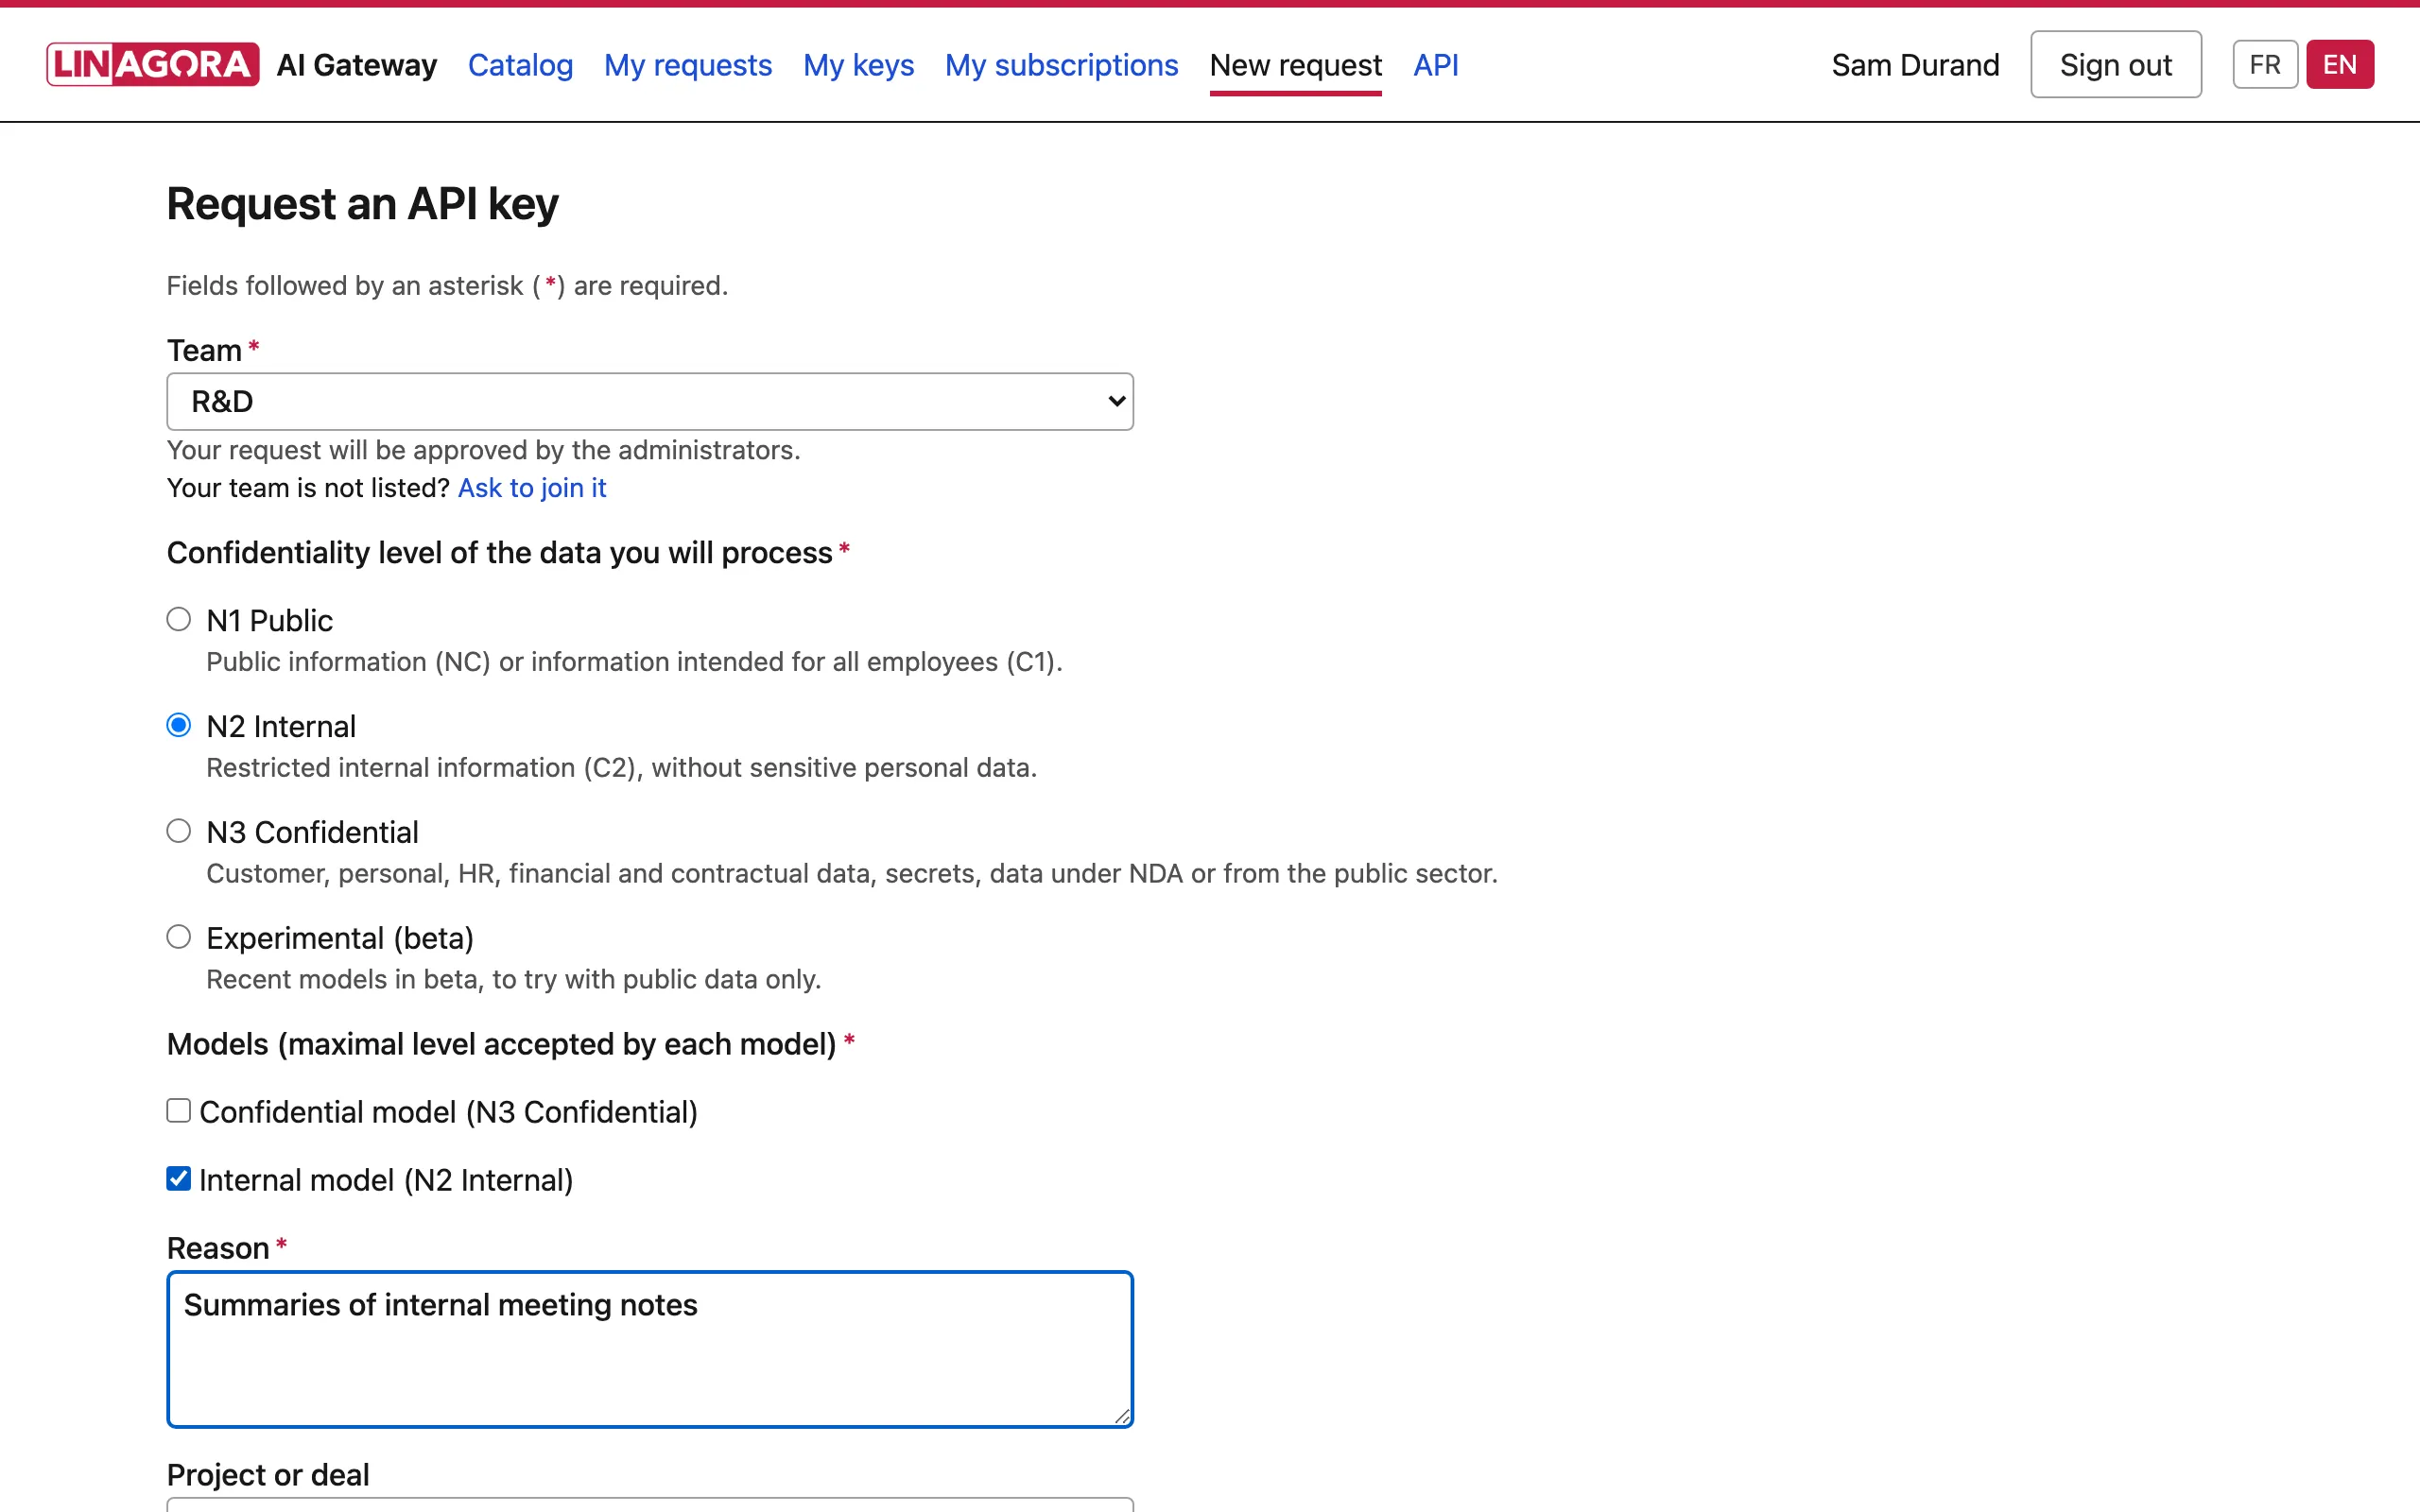
Le circuit est simple. Le collaborateur indique son équipe, le niveau des données qu’il va traiter, les modèles voulus, son projet et la durée souhaitée, et il s’engage à ne pas soumettre de données d’un niveau supérieur. La demande arrive ensuite dans une file de validation.
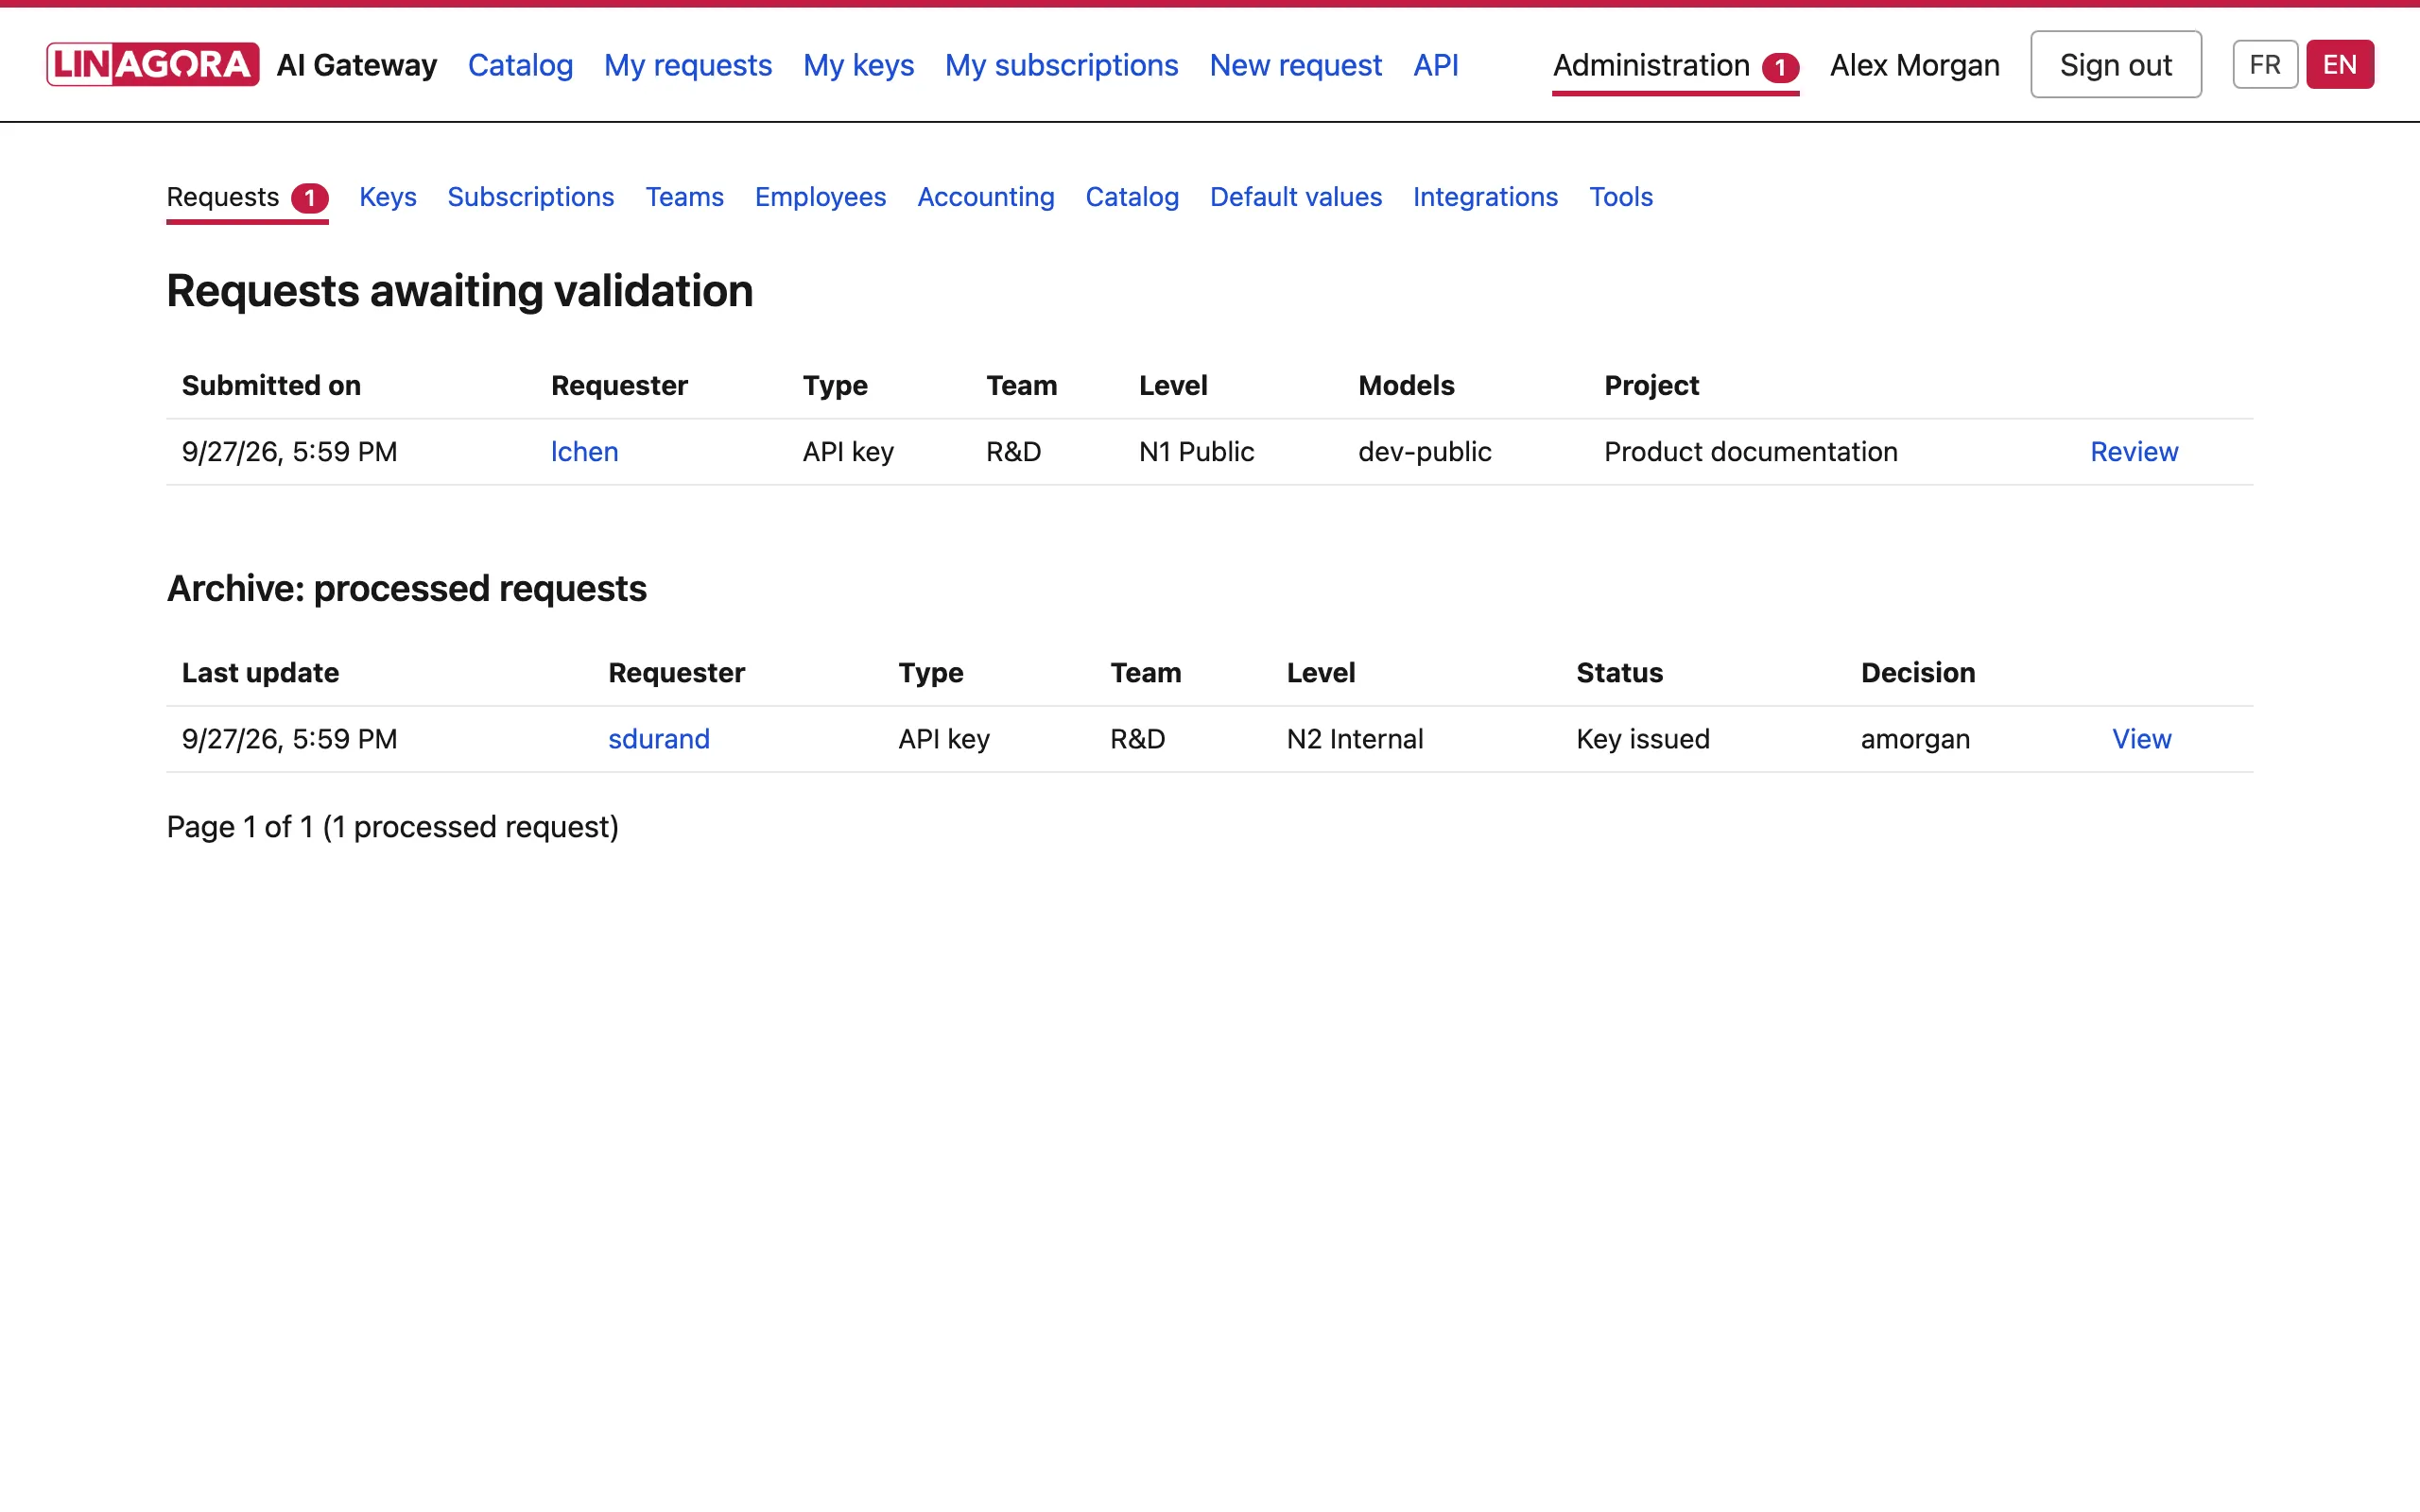
Pour chaque demande, le valideur voit les contrôles de conformité, puis fixe le budget, la période de ce budget et la durée de validité de la clé. Il peut approuver, refuser ou demander des précisions.
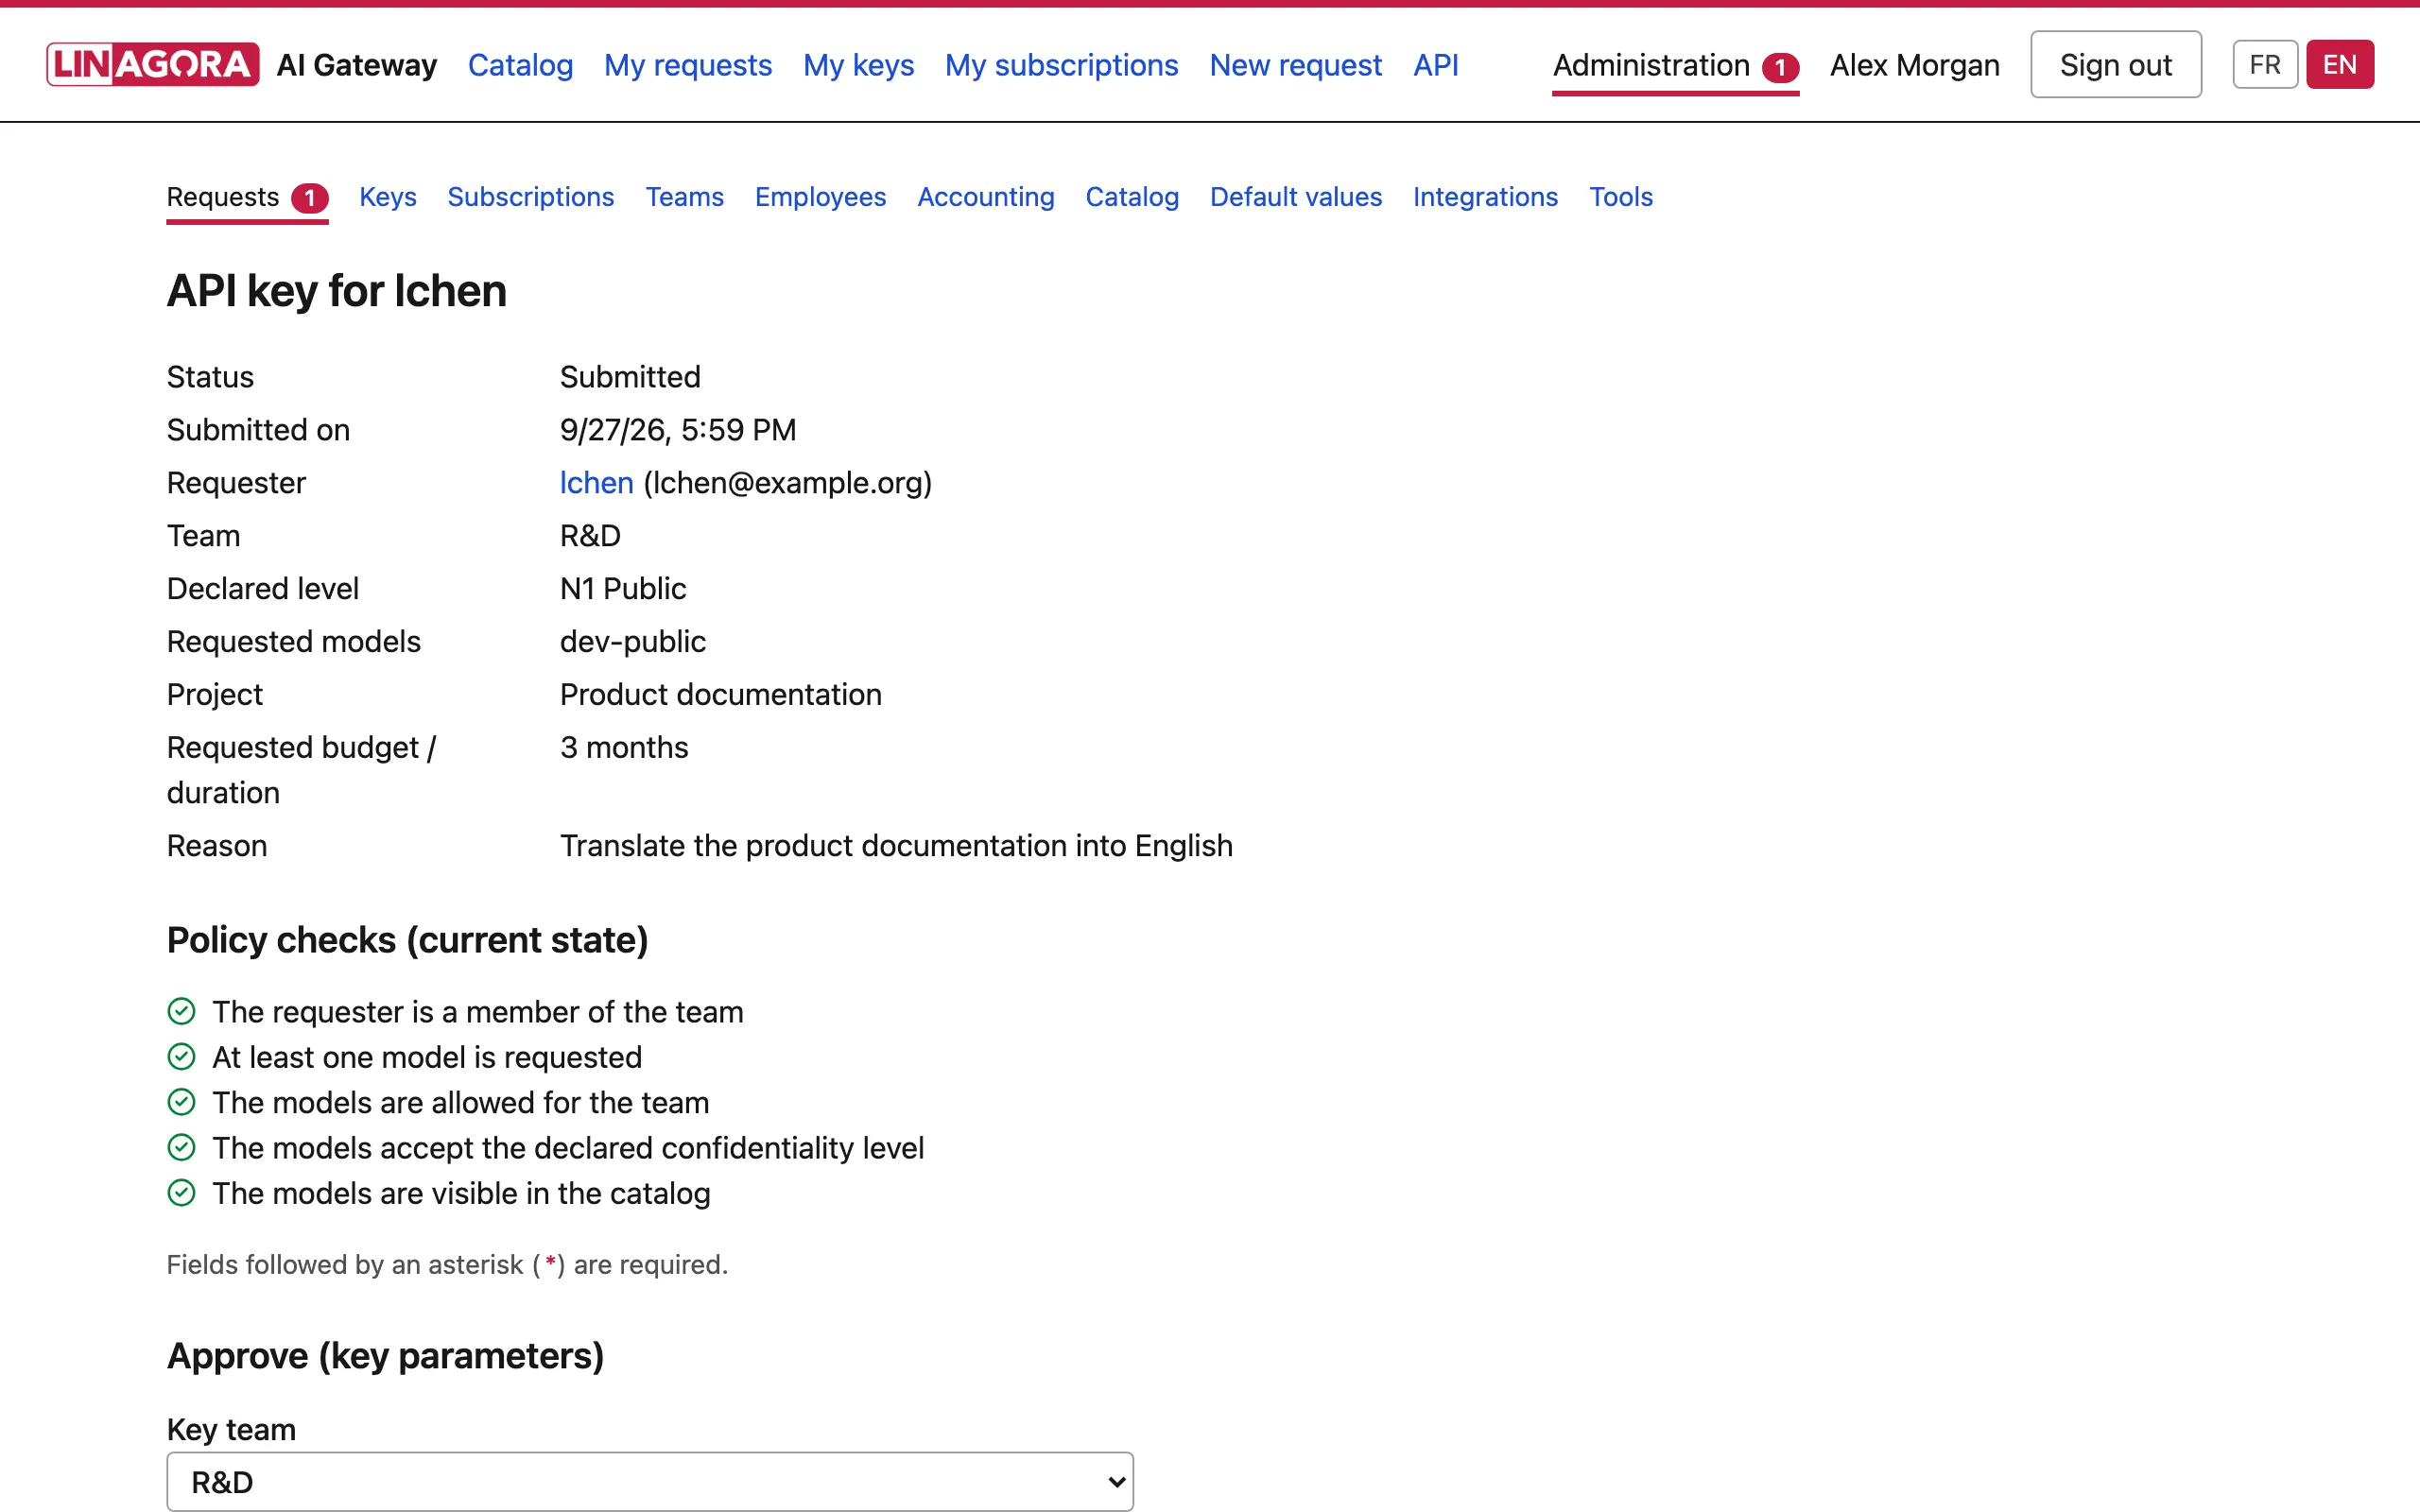
Les données techniques sont ainsi rattachées aux responsabilités, qui a demandé l’accès, qui l’a validé, quelle équipe en répond, quelle application utilise la clé, et à quel projet la dépense est imputée. L’enjeu n’est pas de compter des jetons, mais de savoir qui est responsable de quoi.
Des clés d’API pour les applications et les agents
L’IA ne sert plus seulement à des humains dans une interface de discussion. Elle est intégrée à des applications métier, à des outils de développement, à des automatisations, à des agents et à des chaînes de traitement.
AI Gateway délivre des clés d’API pour ces usages de machine à machine. Chaque application ou service dispose d’un accès identifié, avec son périmètre, son budget et sa date d’expiration. On ne partage plus de clé personnelle ou de secret générique entre plusieurs applications. On peut renouveler, remplacer ou révoquer un accès sans toucher aux autres, une clé révoquée cesse de fonctionner en quelques secondes.
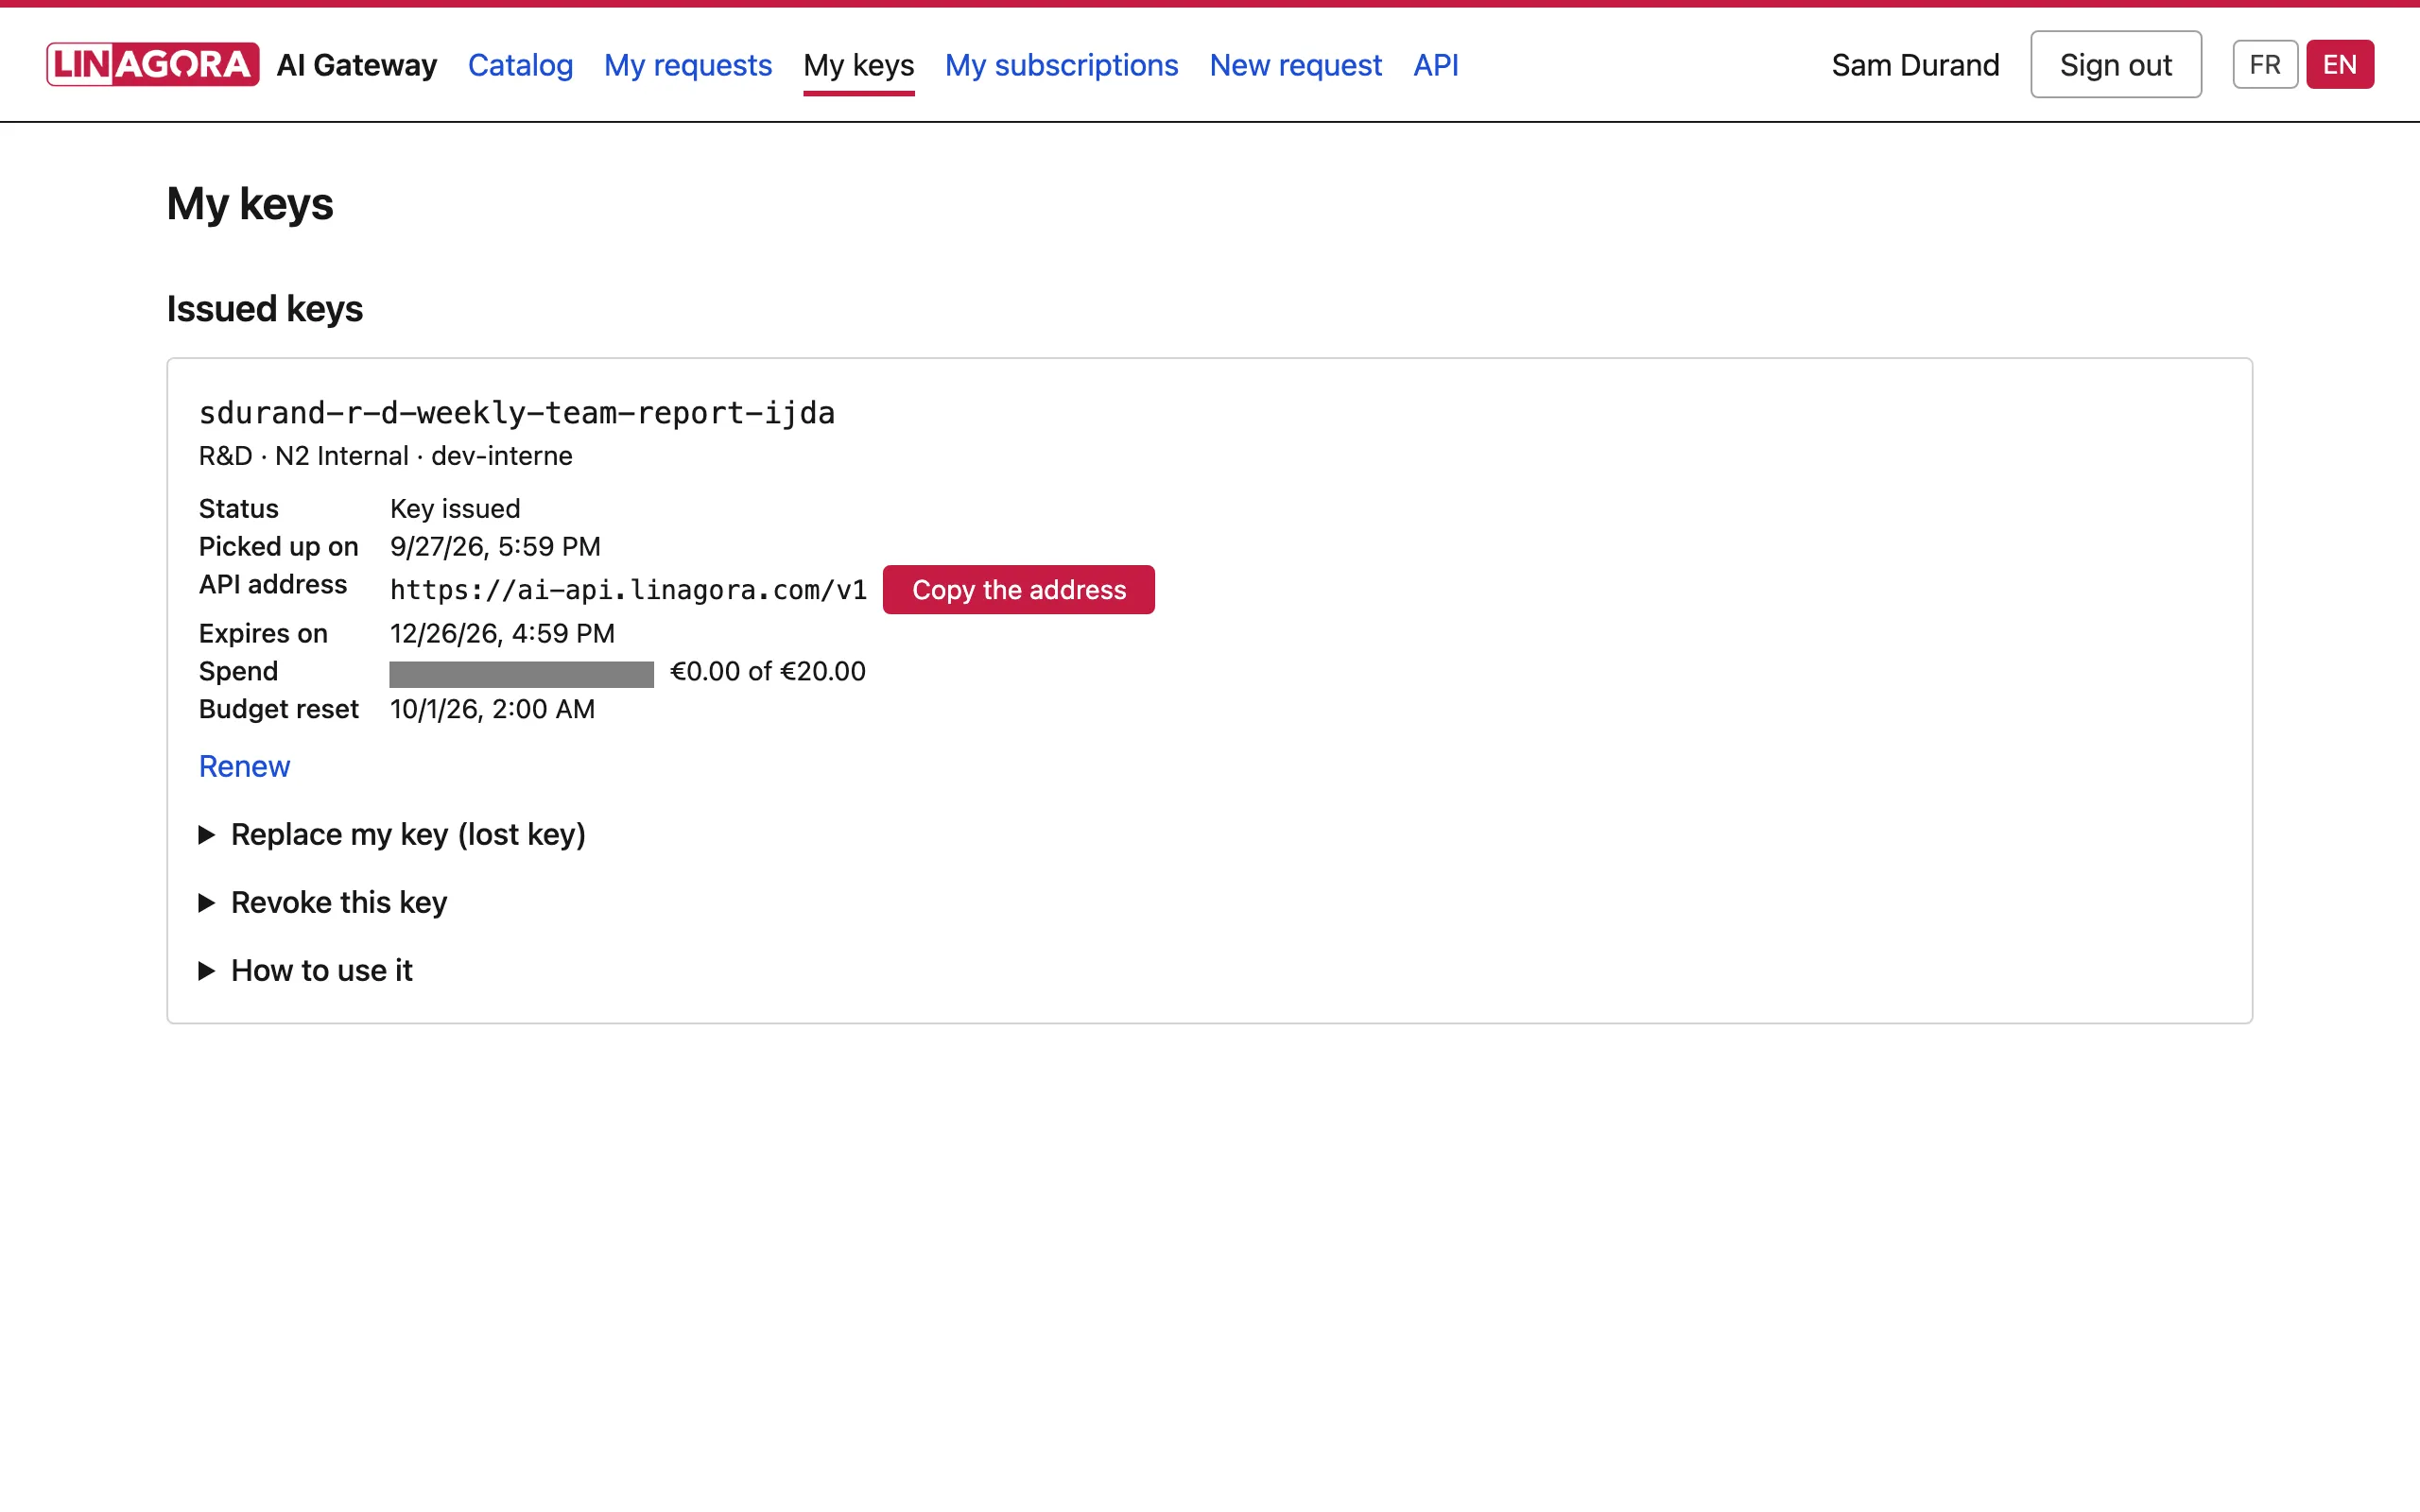
C’est une brique indispensable pour passer de l’expérimentation à la production.
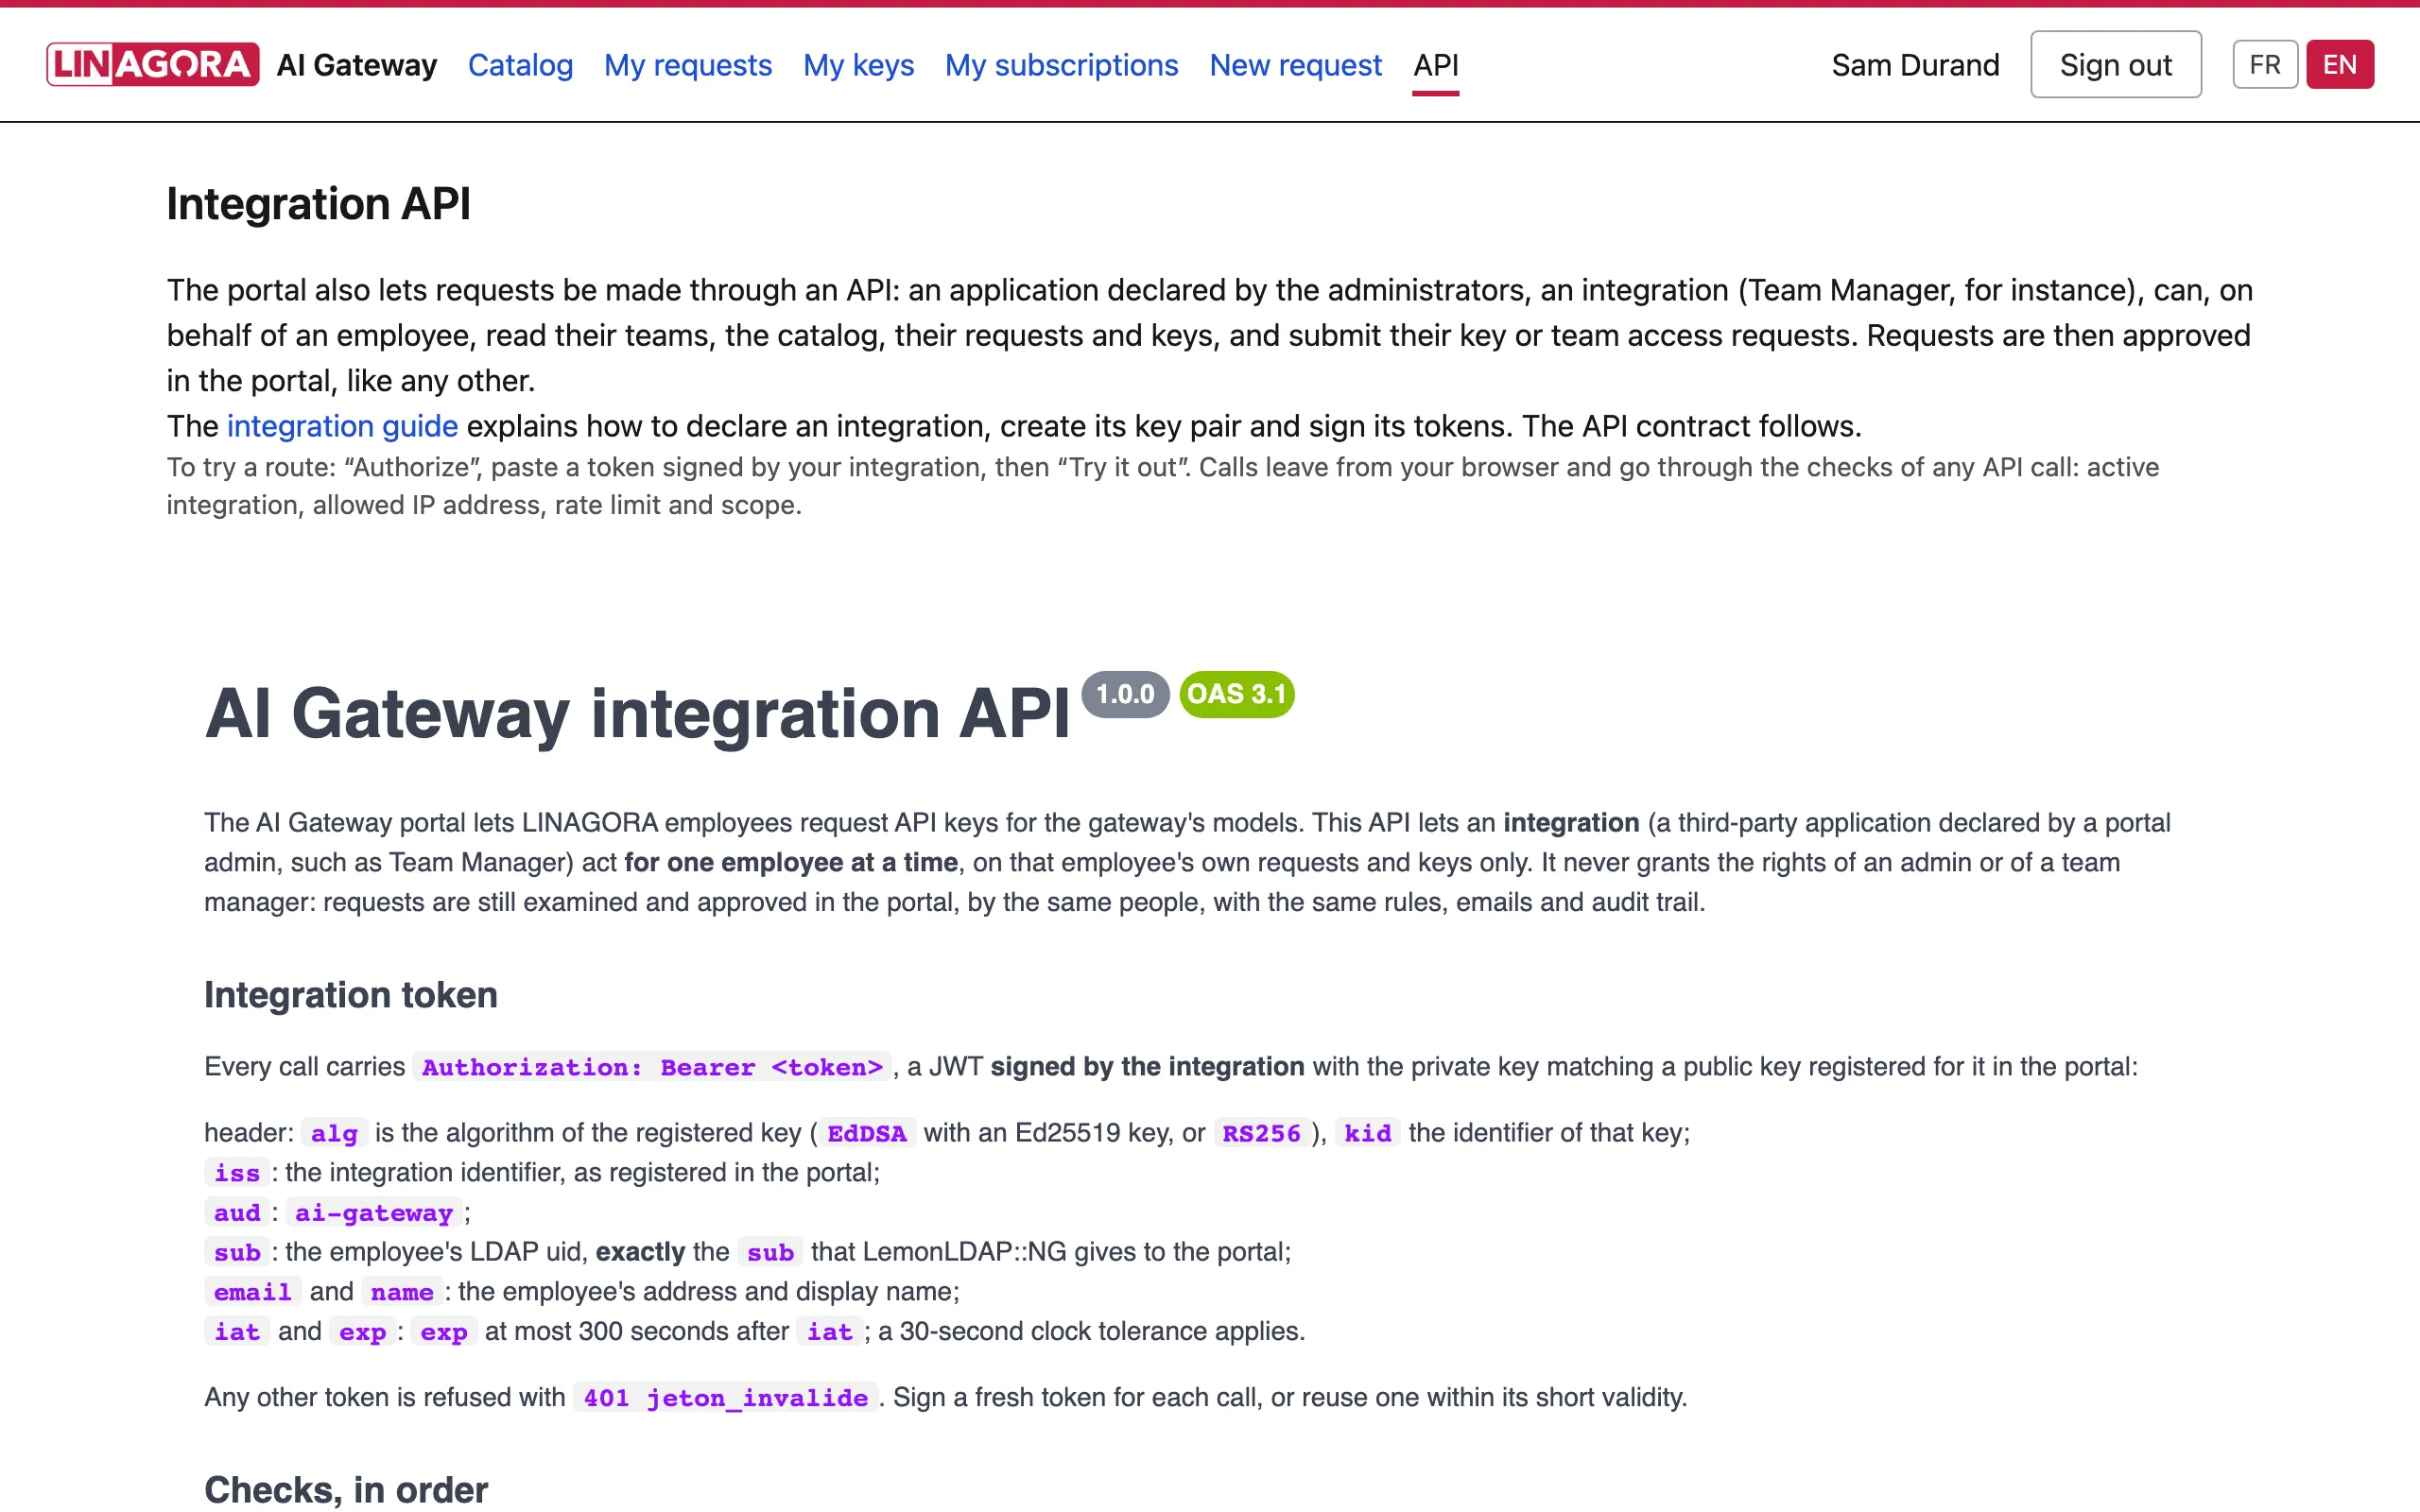
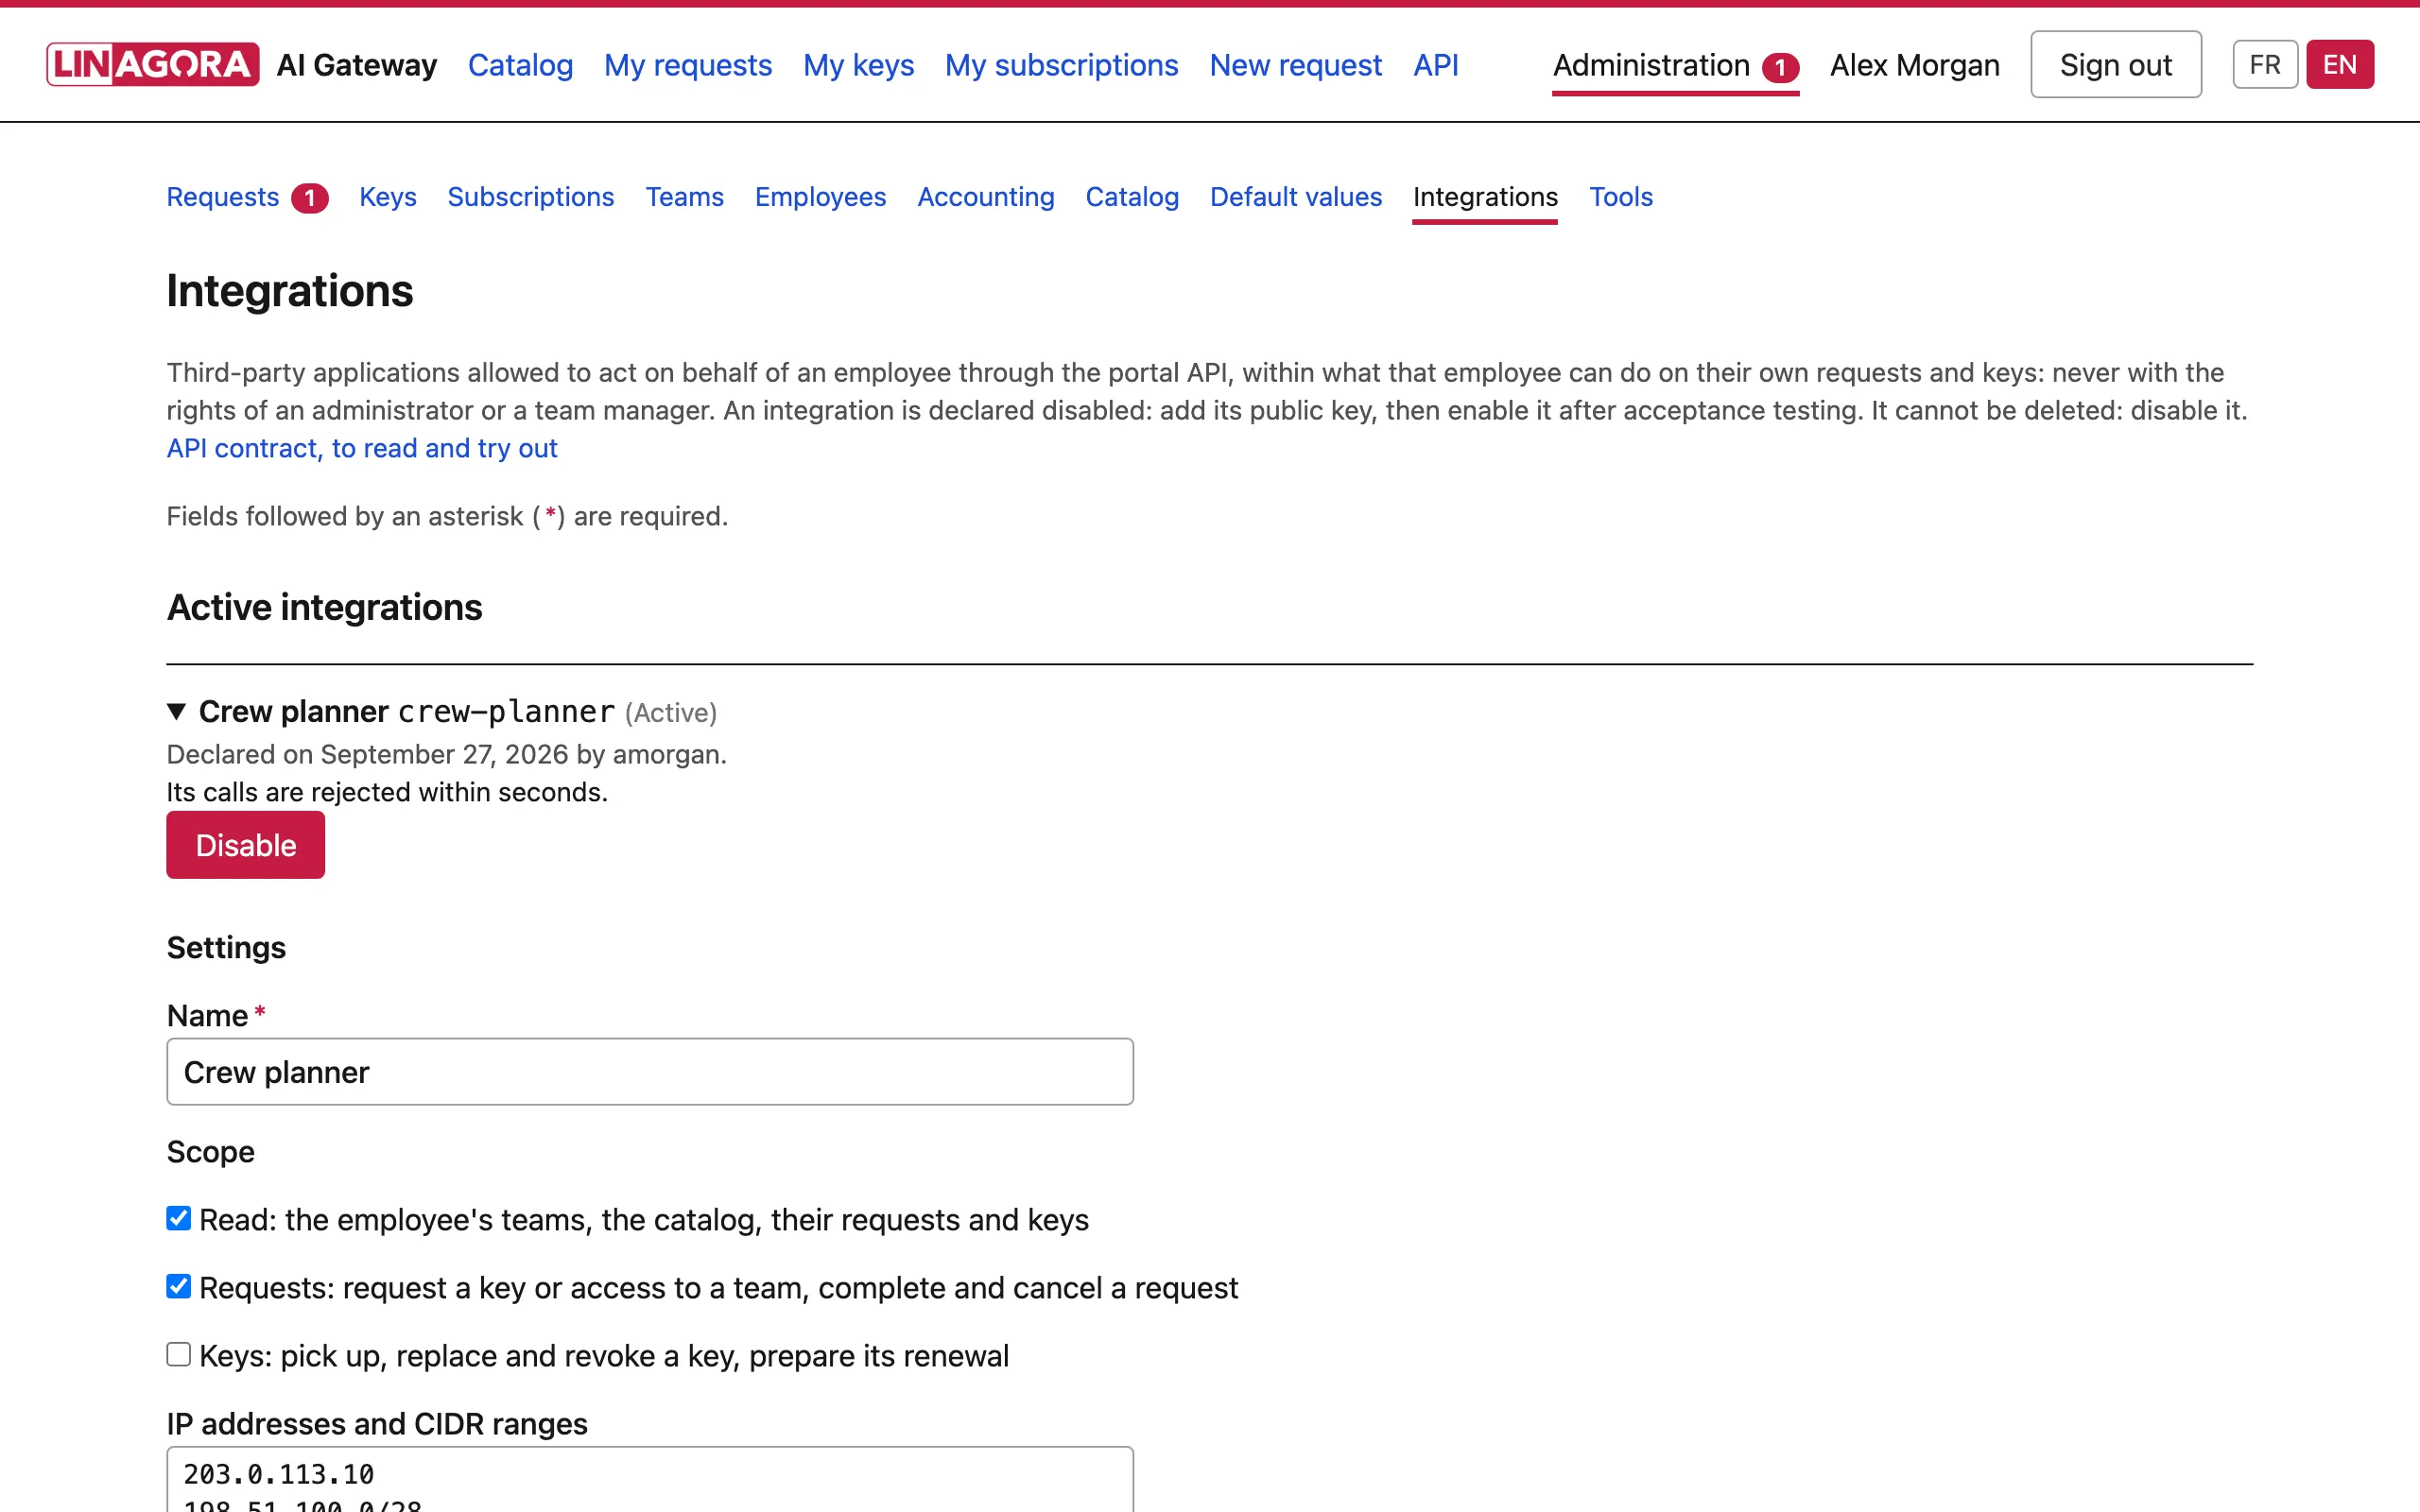
D’autres applications de l’organisation peuvent aussi agir pour le compte d’un collaborateur grâce à une API d’intégration documentée (OpenAPI 3.1). Elles peuvent par exemple consulter le catalogue ou déposer une demande de clé. Les demandes restent validées dans le portail, avec les mêmes règles et la même traçabilité.
Le FinOps appliqué à l’IA
L’IA générative introduit des coûts variables et difficiles à anticiper, par requête, par jeton, par modèle, par abonnement, par fournisseur, par ressource GPU. Il faut maintenant y ajouter le niveau de vitesse demandé.
La bonne question n’est pas seulement « combien avons-nous dépensé ? ». Les plus utiles sont plutôt celles-ci :
- Quel produit, quelle direction ou quel client est à l’origine de cette consommation ?
- Quel cas d’usage apporte une valeur mesurable ?
- Peut-on utiliser un modèle moins cher pour certaines tâches ?
- Quelle part de la dépense va à des services externes, et quelle part à nos propres infrastructures ?
- Un abonnement individuel est-il plus avantageux qu’une clé d’API facturée à l’usage, et le reste-t-il quand le fournisseur modifie son forfait ?
- Faut-il mutualiser, plafonner, budgéter ou refacturer certains usages ?
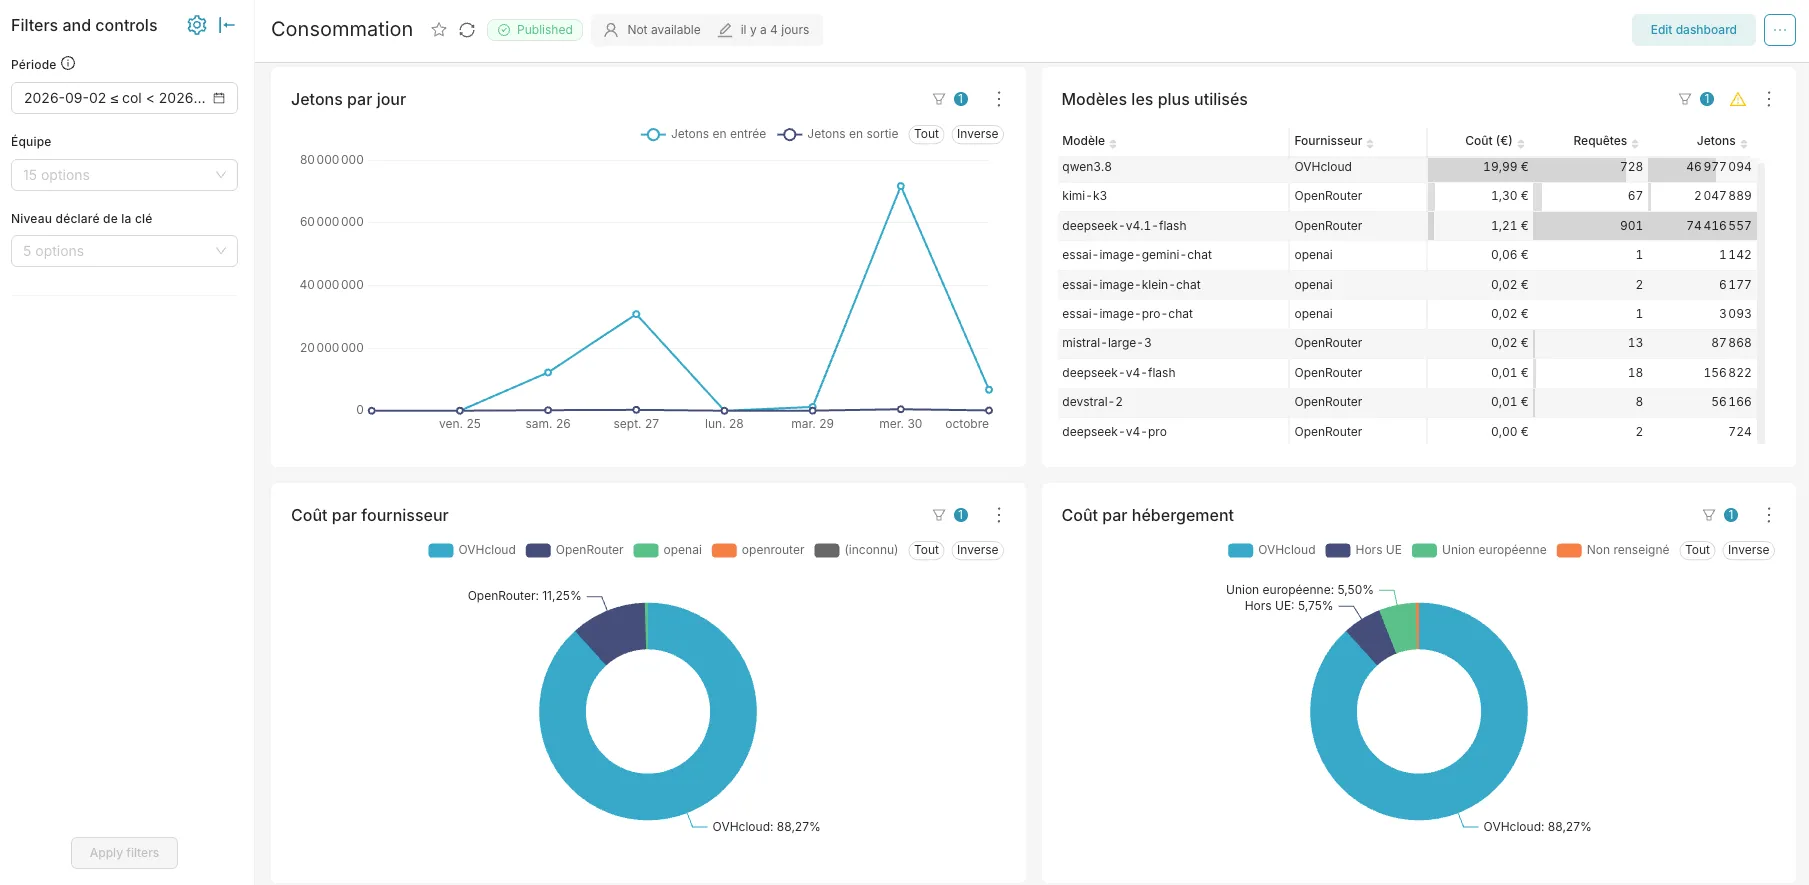
AI Gateway aide à y répondre. Tous les prix sont déclarés en euros, convertis au taux de la BCE en incluant les frais du fournisseur, pour comparer les modèles sur une même base. Des tableaux de bord Apache Superset présentent les coûts, les requêtes et les jetons par équipe, par modèle et par niveau. Les abonnements individuels sont suivis à part, chaque titulaire déclare le montant réellement prélevé, et l’administration exporte ces données pour les remboursements.
Notre configuration chez LINAGORA, trois niveaux de confidentialité et un niveau expérimental
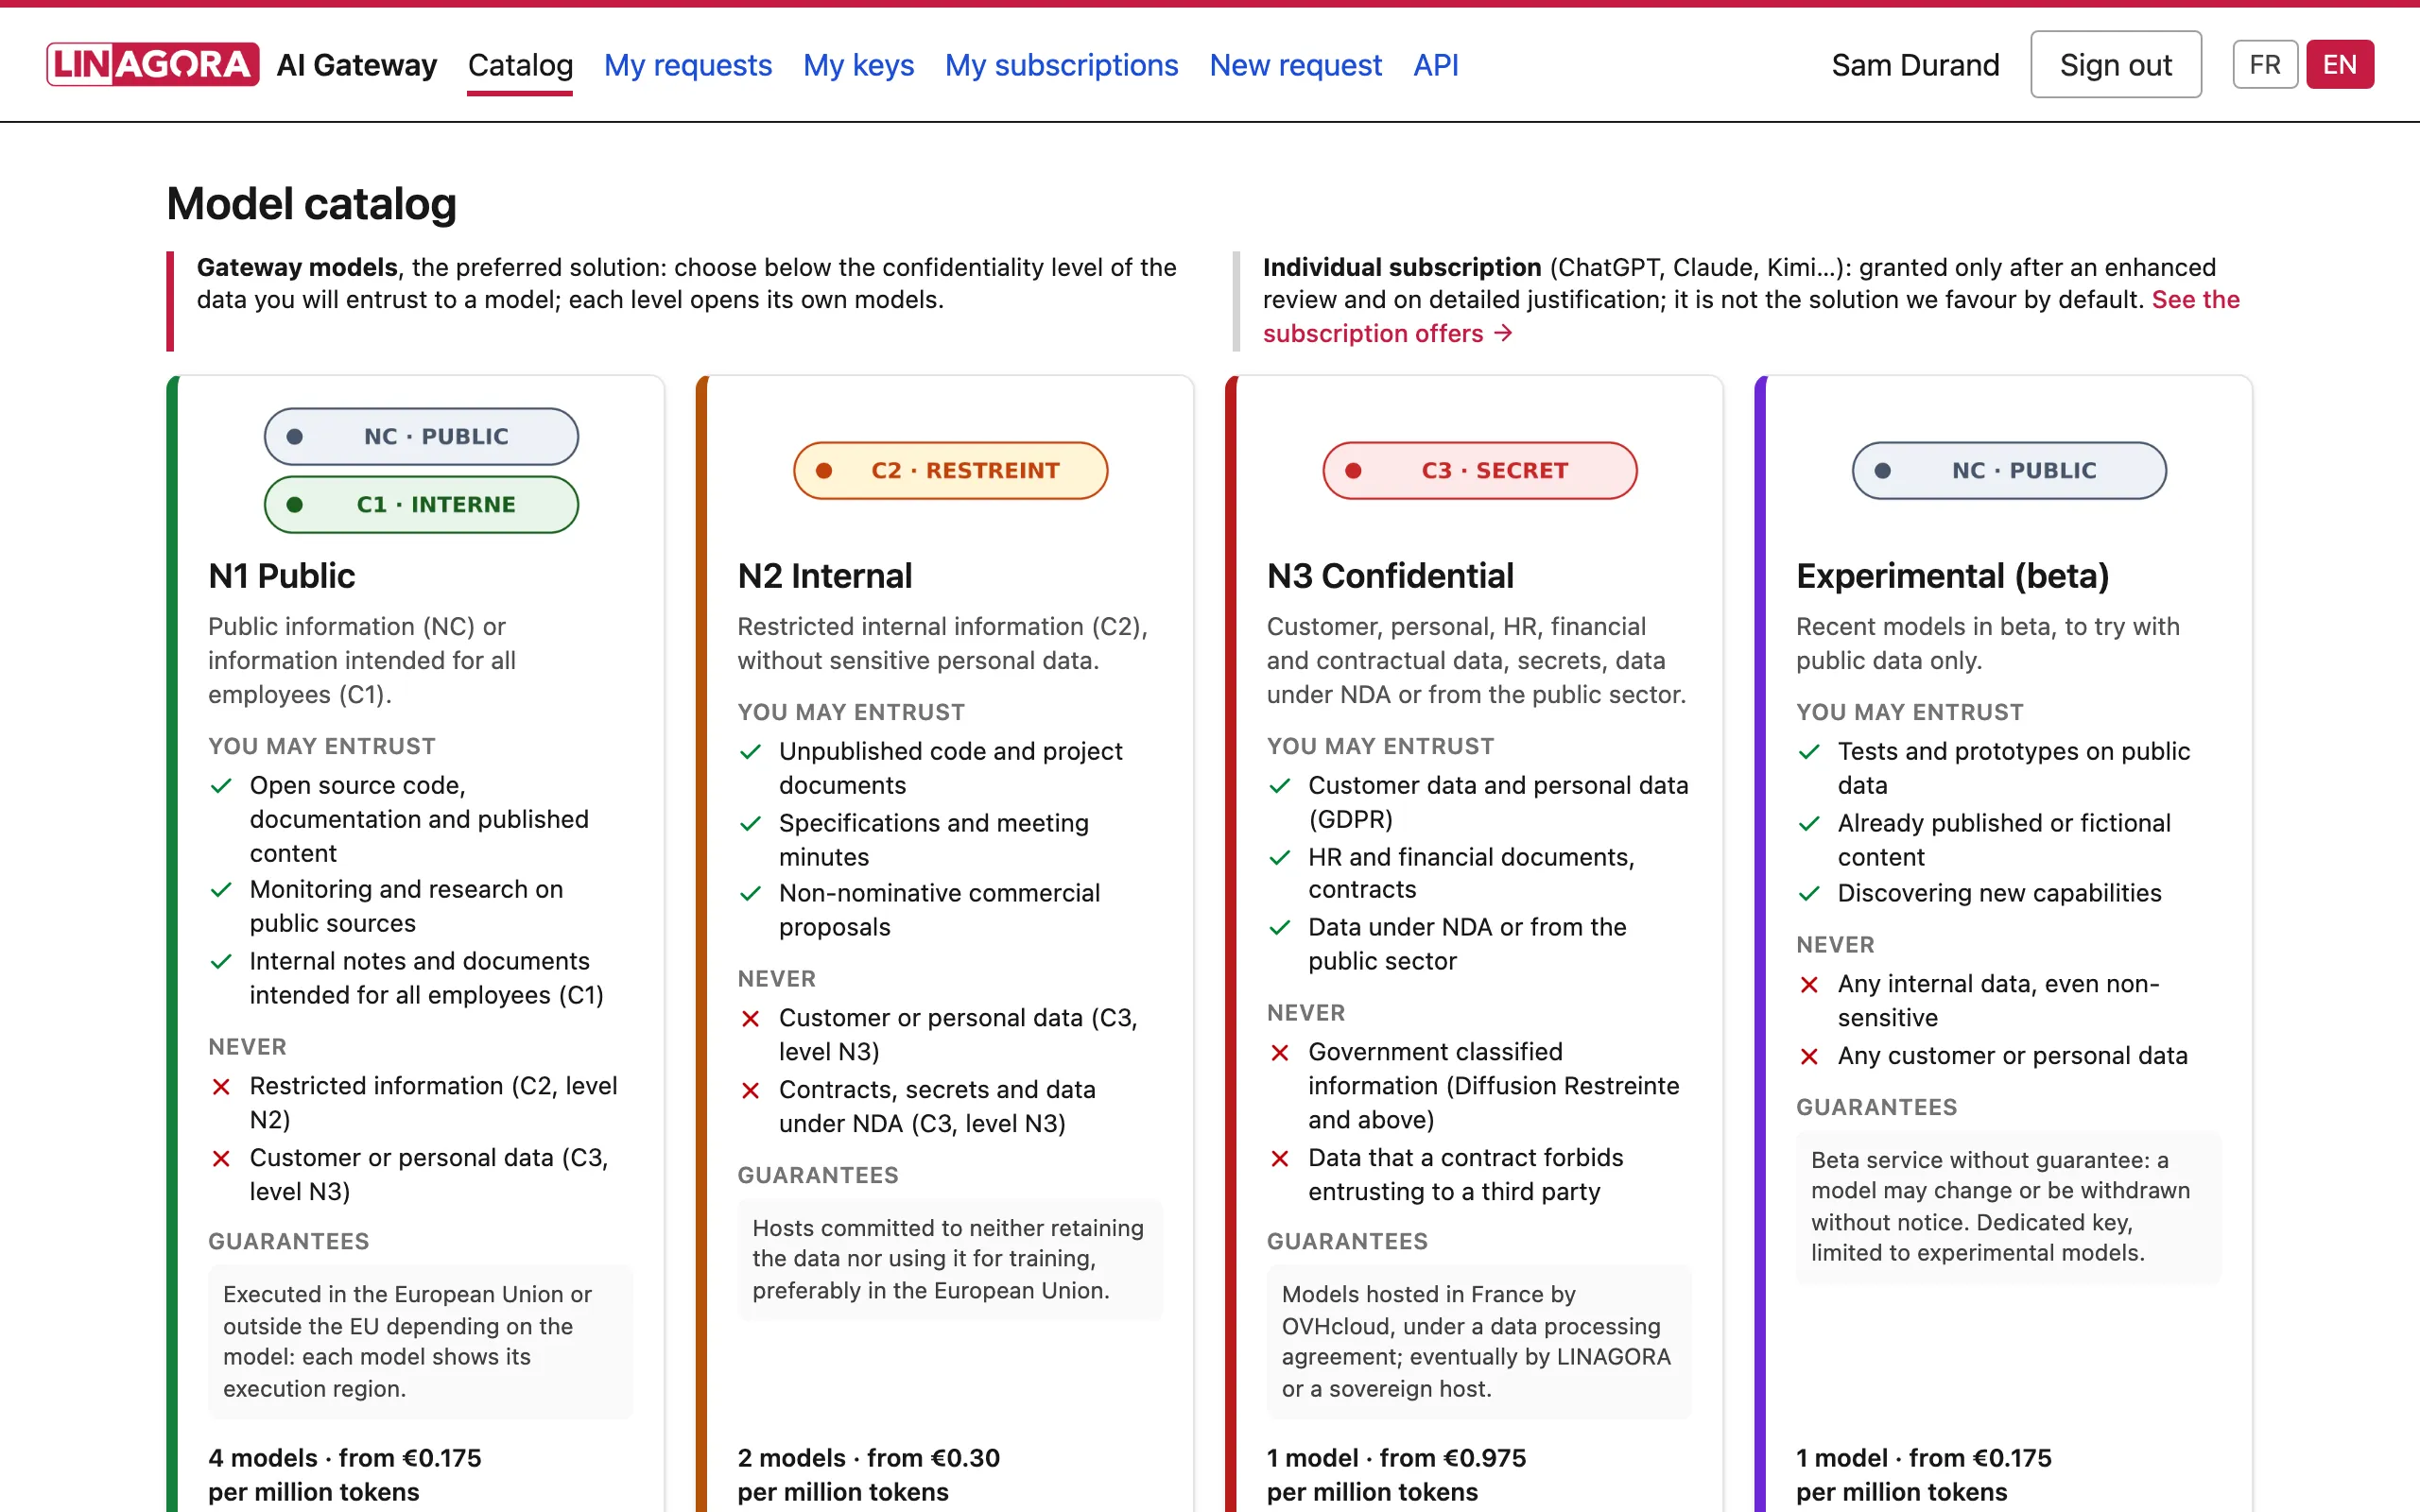
Le catalogue que nous utilisons en interne illustre bien le fonctionnement d’AI Gateway. Il ne part pas des modèles mais des données, le collaborateur choisit d’abord le niveau de confidentialité de ce qu’il va confier, et chaque niveau ouvre ses propres modèles. Les niveaux suivent notre classification interne (NC, C1, C2, C3).
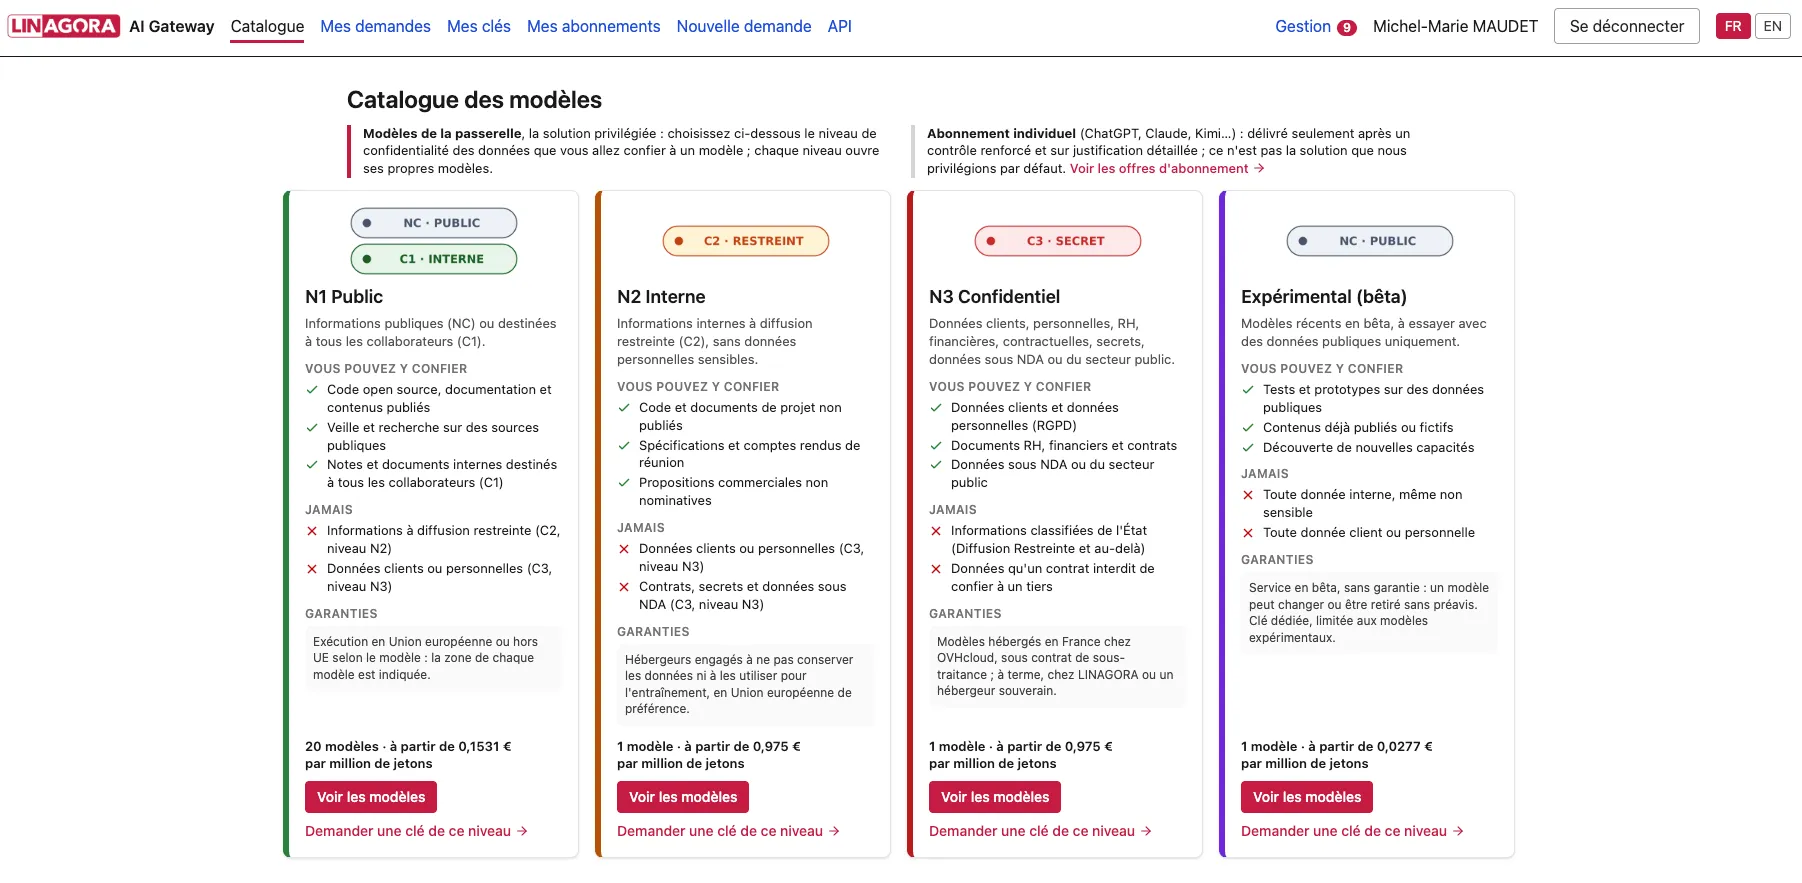
N1 Public, informations publiques (NC) ou destinées à tous les collaborateurs (C1). C’est le niveau qui offre le plus de choix, avec une vingtaine de modèles à partir de 0,15 € par million de jetons. On y trouve Mistral, Gemini Flash, GLM, DeepSeek, Kimi, ainsi que des modèles de génération d’images. Ils sont servis par OpenRouter, mais seuls les modèles inscrits sur une liste blanche sont accessibles. Chaque modèle n’est routé que vers les fournisseurs de sa zone d’exécution, sans repli ailleurs. Les modèles Mistral, Gemini, GLM et DeepSeek tournent en Union européenne ; Kimi et les modèles d’images, faute de fournisseur européen, sont en zone « monde », chez des fournisseurs qui ne conservent pas les données. La zone de chaque modèle est indiquée dans le catalogue. On peut y confier du code open source, de la veille ou des notes internes destinées à tous ; jamais une information à diffusion restreinte, ni une donnée client ou personnelle.
N2 Interne, informations à diffusion restreinte (C2), sans données personnelles sensibles. Il s’agit des documents de projet non publiés, des spécifications, des comptes rendus de réunion ou des propositions commerciales non nominatives. Les hébergeurs s’engagent à ne pas conserver les données et à ne pas les utiliser pour l’entraînement, de préférence en Union européenne.
N3 Confidentiel, données clients, personnelles, RH, financières, contractuelles, secrets et données sous NDA ou du secteur public. Les modèles de ce niveau sont hébergés en France chez OVHcloud (AI Endpoints), sous contrat de sous-traitance. Aujourd’hui, il s’agit de Qwen3.8, facturé 0,40 € HT par million de jetons en entrée et 2,70 € HT en sortie. À terme, ces modèles seront hébergés chez LINAGORA ou chez un hébergeur souverain. Même à ce niveau, une limite reste explicite, les informations classifiées de l’État (Diffusion Restreinte et au-delà) n’ont pas leur place sur la passerelle, pas plus que les données qu’un contrat interdit de confier à un tiers.
Expérimental (bêta), les nouveautés, avec des données publiques uniquement. Le marché évolue chaque semaine et nos équipes veulent tester les nouveaux modèles dès leur sortie. Plutôt que de les laisser ouvrir des comptes de leur côté, nous avons créé un niveau à part. Il fonctionne avec une clé dédiée, limitée aux modèles expérimentaux, et sans aucune garantie, un modèle peut changer ou disparaître sans préavis. On ne peut y confier que des données publiques, fictives ou déjà publiées, jamais une donnée interne, même peu sensible.
C’est par ce niveau que nous avons ouvert JEV, le modèle de Typesafe dont tout le monde parle depuis sa sortie en bêta mi-septembre. JEV n’est pas un modèle de conversation mais un modèle « System One ». Il ne produit pas de texte libre, il reçoit l’état d’une application et une question typée, et renvoie une décision structurée, avec une probabilité associée. Il coûte 0,042 $ par million de jetons en entrée, et sa sortie est gratuite (OpenRouter, Typesafe API and Models). C’est exactement la catégorie que vise la Decisions API d’OpenAI, de petits modèles rapides et très bon marché, chargés des décisions répétitives (classer, trier, router) que l’on confiait jusqu’ici à de grands modèles bien plus chers. Typesafe propose d’ailleurs un routeur, Jev Router, qui choisit pour chaque requête le modèle et l’effort de raisonnement en fonction de la qualité, de la vitesse et du coût. C’est une piste d’optimisation sérieuse pour la facture d’IA, et c’est pour cela que nous voulons l’évaluer.
Typesafe n’ouvrant plus de compte en direct, JEV passe par l’API System One d’OpenRouter. Nous l’avons intégré à la passerelle comme fournisseur personnalisé de LiteLLM, en quelques dizaines de lignes, clés, budgets et coûts sont suivis comme pour n’importe quel autre modèle. C’est tout l’intérêt d’une passerelle ouverte, une nouveauté sortie il y a quinze jours est testable en interne, avec ses garde-fous, sans qu’aucun collaborateur ait à ouvrir de compte ni à saisir sa carte bancaire.
Deux choix complètent ce dispositif.
- Aucun modèle fermé haut de gamme (Anthropic, OpenAI) n’est servi par la passerelle. Ceux qui en ont besoin peuvent demander un abonnement individuel (ChatGPT, Claude, Kimi…). Il est accordé après un contrôle renforcé et sur justification détaillée. Le portail rappelle les réglages à faire avant tout usage, comme la désactivation de l’entraînement sur les conversations, et suit les montants prélevés. Ce n’est pas la solution que nous privilégions par défaut, et les annonces d’OpenAI nous confortent dans ce choix, un forfait dont le contenu peut être divisé par deux d’un mois sur l’autre doit rester une exception justifiée et suivie, pas un réflexe.
- Une garde empêche de contourner les règles. Une requête ne peut pas changer de modèle ou de fournisseur par ses paramètres (modèles de repli, préférences de fournisseur, préréglages), ni utiliser des API dont le coût échapperait au budget des clés. Le contenu des requêtes et des réponses n’est jamais conservé dans les journaux de dépense, et le détail par requête est purgé au bout de 90 jours.
Gouverner sans payer une rente logicielle
Mettre en place une gouvernance de l’IA a un coût. Il faut déployer, administrer, sécuriser, superviser et maintenir une plateforme fiable. L’open source ne fait pas disparaître ces réalités.
En revanche, les solutions de gouvernance vendues en SaaS ajoutent souvent leur propre facturation aux dépenses d’IA, par utilisateur, par environnement, par volume de requêtes, par données analysées, ou sous forme de forfaits mensuels.
Pour donner un ordre de grandeur, ces services peuvent coûter plusieurs dizaines d’euros par utilisateur et par mois. Pour une organisation de 50 personnes, une plateforme facturée entre 35 et 45 € par utilisateur représenterait 1 750 à 2 250 € par mois, avant même le coût des modèles, des abonnements et des infrastructures GPU. D’autres offres reposent sur des forfaits de plusieurs centaines ou milliers d’euros par mois, ce qui pèse lourd pour de petites équipes ou pour des structures qui ne mutualisent pas encore leurs usages (Kong Konnect ; Gravitee ; Orq.ai ; innFactory).
Publier AI Gateway en open source change cette équation.
AI Gateway ne facture ni licence par utilisateur ni commission sur les jetons. Les organisations paient toujours ce que coûtent réellement leurs usages, fournisseurs de modèles, abonnements, GPU, hébergement, stockage, supervision et exploitation. Mais elles n’ajoutent pas une licence propriétaire par-dessus.
Les économies d’échelle deviennent possibles. Une même instance peut servir plusieurs équipes, applications, directions, filiales ou clients. Plus les usages augmentent, plus le coût de la plateforme par usage diminue, puisque le socle logiciel est commun.
Pour une collectivité, un groupement d’acteurs publics, une administration ou une organisation à plusieurs entités, cette mutualisation peut être décisive. On peut déployer un cadre commun de gouvernance et de suivi sans que le coût explose à mesure que de nouveaux agents, services ou applications utilisent l’IA.
Un commun à construire ensemble
Nous avons développé AI Gateway pour nos propres besoins. Nous utilisons plusieurs types de modèles, plusieurs modes d’accès et plusieurs infrastructures, et il nous fallait un outil pour rendre ces usages visibles, gouvernables et pilotables.
Nous savons que nous ne sommes pas les seuls dans ce cas.
C’est pourquoi nous publions AI Gateway comme un commun numérique, à la disposition des entreprises, administrations, collectivités et organisations qui veulent reprendre la maîtrise de leurs usages de l’IA.
Cette démarche prolonge des projets comme OVH Cost Manager, avec la même idée, rendre visible une dépense technique qui, sans instrumentation ni gouvernance, devient vite difficile à comprendre, à répartir et à optimiser.
OVH Cost Manager nous a aussi appris que la communauté ne se contente pas d’utiliser un logiciel. Elle partage ses questions, ses besoins, ses retours d’exploitation, ses difficultés d’intégration et ses propositions d’évolution, et ce dialogue fait avancer le projet à partir de cas concrets.
Nous voulons la même dynamique pour AI Gateway. Les organisations qui l’expérimentent, celles qui veulent le déployer et celles qui ont des besoins nouveaux sont invitées à contribuer, par exemple en :
- partageant un retour d’expérience de déploiement ou d’exploitation ;
- décrivant un cas d’usage métier, technique, financier ou réglementaire ;
- proposant une évolution fonctionnelle ou une amélioration de l’interface ;
- signalant un problème, un manque dans la documentation ou un besoin d’intégration ;
- participant au développement, aux tests et à la qualité du logiciel ;
- partageant des modèles de gouvernance, des classifications de données ou des pratiques FinOps appliquées à l’IA.
Le code est ouvert, mais un commun ne vit vraiment que si une communauté s’en empare. Nous voulons construire AI Gateway avec celles et ceux qui, chaque jour, déploient l’IA dans des environnements complexes.
Le dépôt du projet est ici, linagora/ai-gateway.
Une architecture ouverte et intégrable
AI Gateway est une brique de gouvernance qui s’intègre au système d’information existant, pas un environnement d’IA fermé.
Son architecture sépare nettement le portail (expérience utilisateur et administration), la gestion des identités et des accès, le routage des requêtes vers les modèles, et le suivi des consommations. Grâce à cette séparation, une organisation peut faire évoluer ses usages, ses fournisseurs et ses infrastructures sans reconstruire toute sa plateforme à chaque changement technologique.
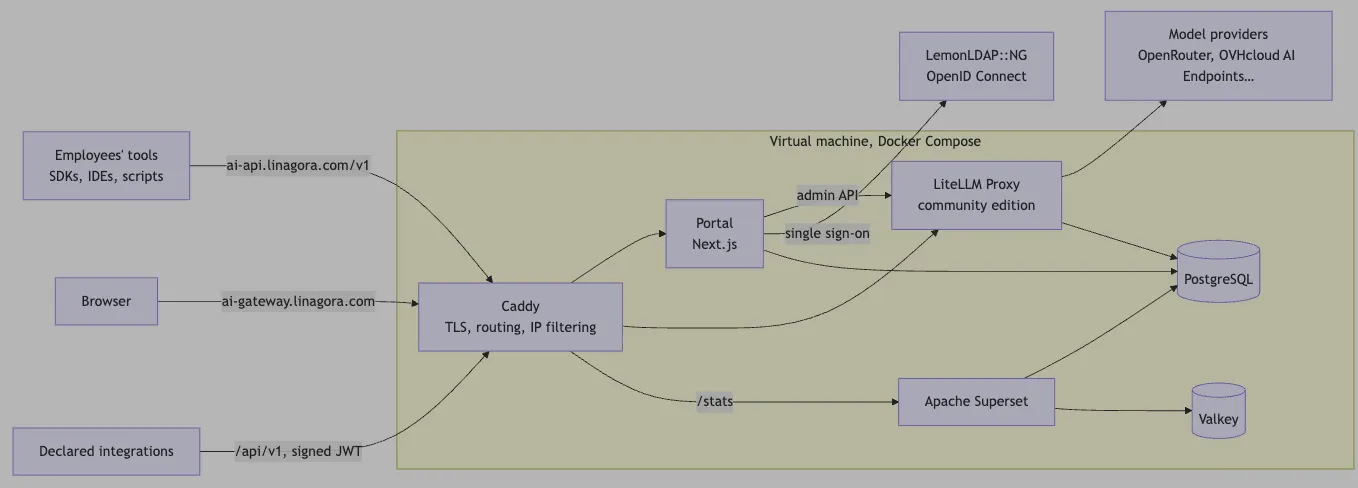
On peut la décrire en cinq ensembles.
Le portail de gouvernance
Le portail est le point d’entrée des utilisateurs et des administrateurs. On y trouve le catalogue des modèles, les abonnements disponibles, les demandes d’accès, les équipes et le suivi des consommations.
Ce n’est pas une simple console technique, c’est là que se pratique la gouvernance au quotidien. On y demande un accès, on choisit un modèle adapté à la sensibilité de ses données, on récupère une clé d’API et on suit les usages de son équipe ou de son projet. Le portail et ses notifications par e-mail existent en français et en anglais.
L’identité et le contrôle des accès
L’utilisateur se connecte avec son identité professionnelle via OpenID Connect. La plateforme applique alors des règles cohérentes avec son rôle, son équipe, ses autorisations et les données qu’il manipule.
Cette brique porte aussi les circuits de gouvernance, demande d’accès, validation, attribution d’un abonnement, création d’une clé, rattachement à un projet ou à une équipe, révocation. La même session d’authentification protège la console d’administration de LiteLLM et les tableaux de bord Superset.
Le catalogue et les règles de sélection
Le catalogue est la première décision proposée à l’utilisateur. Il n’expose pas tous les modèles disponibles indifféremment, l’organisation les documente, les classe et les présente selon la sensibilité des données, les exigences d’hébergement, la souveraineté, les performances, les coûts et les cas d’usage autorisés.
C’est ici que la gouvernance rejoint l’expérience utilisateur. Un collaborateur qui veut résumer un document public est orienté vers un modèle courant et économique. Une équipe qui manipule des données sensibles est dirigée vers un modèle dont l’hébergement respecte les règles de l’organisation. Un développeur qui intègre l’IA dans une application obtient un accès par API, avec sa propre clé et son propre suivi.
La passerelle vers les modèles
Derrière le portail, la passerelle s’appuie sur l’édition communautaire de LiteLLM Proxy. Elle expose un point d’accès unique, compatible avec n’importe quel SDK OpenAI, et relaie les requêtes vers les fournisseurs et vers les modèles opérés en interne.
Une organisation peut ainsi combiner plusieurs stratégies dans une même architecture :
- des services d’IA accessibles par des API externes ;
- des modèles open source servis par des fournisseurs spécialisés ;
- des modèles hébergés dans un cloud souverain ;
- des modèles déployés sur ses propres serveurs GPU ;
- des modèles Luciole opérés par LINAGORA, quand ils conviennent au cas d’usage ;
- des modèles d’un genre nouveau, comme les modèles de décision, intégrés comme fournisseurs personnalisés.
L’organisation n’est pas enfermée chez un fournisseur. Elle peut en changer, tester un nouveau modèle, basculer certains usages vers son infrastructure ou appliquer des règles propres à certaines équipes et à certaines données.
La passerelle est aussi le point de contrôle commun de tous les appels faits par les applications, les automatisations et les agents. C’est ce qui permet de rattacher chaque consommation à une clé, une équipe, un projet, un client ou un cas d’usage.
L’observabilité et le pilotage FinOps
Enfin, AI Gateway relie chaque usage aux informations nécessaires pour le gouverner, consommation, coût, fournisseur, modèle, clé, équipe et périmètre de responsabilité.
On sort ainsi d’une vision éclatée, où chaque fournisseur a ses propres tableaux de bord et ses propres unités de facturation, pour rapprocher les consommations de la structure réelle de l’organisation.
L’objectif n’est pas d’ajouter un tableau de bord de plus, mais d’obtenir des informations sur lesquelles agir :
- repérer les modèles les plus utilisés et les cas d’usage les plus gourmands ;
- répartir les dépenses entre équipes, projets, applications ou clients ;
- comparer les coûts entre fournisseurs et entre modèles ;
- détecter les usages anormaux ou non attribués ;
- ajuster les accès, les budgets et les recommandations du catalogue ;
- préparer une mutualisation entre plusieurs entités, notamment dans le secteur public.
Le traçage détaillé des appels avec Langfuse est la prochaine étape prévue.
Une pile technique pensée pour durer
AI Gateway repose sur des composants open source éprouvés et sur des standards du web et du cloud :
| Composant | Rôle |
|---|---|
| Caddy | Proxy inverse, TLS automatique, filtrage par adresse IP, contrôle d’accès |
| LiteLLM Proxy, édition communautaire | Passerelle compatible OpenAI, clés, budgets, journaux de dépense, fournisseurs |
| Portail Next.js, Auth.js, Prisma | Demandes, validations, clés, équipes, abonnements, catalogue, API d’intégration |
| PostgreSQL | Bases de LiteLLM et du portail, vues de reporting |
| Apache Superset et Valkey | Tableaux de bord et leur cache |
| LemonLDAP::NG | Authentification unique (OpenID Connect) |
L’ensemble tourne sur une seule machine virtuelle avec Docker Compose. Seul Caddy expose des ports. Chaque image tierce est figée par étiquette et par empreinte, et les versions de LiteLLM sont vérifiées par leur signature avant usage. Un guide d’installation détaille le déploiement étape par étape, avec les vérifications à chaque phase.
Ces choix répondent à plusieurs objectifs :
- Interopérabilité, s’intégrer aux systèmes d’identité, aux environnements cloud, aux fournisseurs de modèles et aux infrastructures existantes.
- Réversibilité, éviter qu’un choix de fournisseur ou d’hébergement devienne irréversible.
- Sécurité, gérer de façon structurée les identités, les autorisations, les secrets et les clés.
- Industrialisation, déployer de manière reproductible, exploiter, superviser et faire évoluer la plateforme dans la durée.
- Souveraineté, déployer là où l’organisation le décide, y compris sur ses propres infrastructures.
- Contribution, rendre l’architecture lisible pour que d’autres puissent l’auditer, l’adapter et l’enrichir.
Nous avons fait un choix pragmatique, nous appuyer sur les standards existants et construire les fonctions de gouvernance qui manquent vraiment quand l’IA se généralise.
Cette transparence est aussi une condition de confiance. Une organisation qui confie à une plateforme ses accès à l’IA, ses clés et ses données de consommation doit pouvoir comprendre son architecture et rester capable de l’opérer elle-même.
Une première version, et peut-être une offre SaaS
AI Gateway est un projet jeune, mais ses fondations répondent déjà à un besoin immédiat, disposer d’un point de passage ouvert, intégrable et gouvernable pour gérer les accès, les équipes, les modèles, les clés et les consommations liées à l’IA.
Il s’enrichira des retours de ses utilisateurs et des besoins de la communauté. Les cas d’usage ne manquent pas, gouvernance de l’IA au sein d’une DSI, pilotage de plusieurs fournisseurs, mise à disposition sécurisée de modèles pour les directions métier, exposition de modèles internes à des applications et à des agents, suivi des usages par client, partenaire ou filiale.
Nous réfléchissons aussi à proposer nous-mêmes une offre SaaS. Il ne s’agirait ni de fermer le logiciel, ni de réserver des fonctions à une édition propriétaire, le code resterait ouvert et l’auto-hébergement possible.
Cette offre s’adresserait aux organisations qui veulent aller vite (collectivités, administrations, PME, entreprises, groupements) et qui ont besoin d’un portail prêt à l’emploi pour suivre leurs usages et leurs consommations, sans avoir à opérer tout de suite l’infrastructure. Elle garderait les principes qui nous importent, transparence, réversibilité, maîtrise des données, auditabilité et absence de dépendance à un logiciel fermé.
L’IA ne doit devenir une boîte noire ni sur le plan technique, ni sur le plan budgétaire, ni sur le plan organisationnel. Les fournisseurs changent leurs prix, leurs forfaits et leurs modèles tous les mois, c’est une raison de plus pour garder la main sur ses propres usages.
L’IA peut être un formidable levier de transformation, à condition de la déployer avec discernement, de connaître précisément ses usages et d’en assumer collectivement la gouvernance.
C’est l’ambition d’AI Gateway, permettre à chaque organisation de faire de l’IA un service utile, maîtrisé, souverain et gouvernable, et construire ensemble les outils communs dont cette ambition a besoin.
À lire aussi sur ce carnet
- Les agents IA deviennent plus autonomes. Pourquoi les comprenons-nous de moins en moins ? , l’autre face du même sujet, quand c’est la boucle agentique qui échappe à la gouvernance et pas seulement la facture.
- Le harnais est devenu un champ de bataille et l’Europe a une carte à y jouer , l’infrastructure côté exécution, où AI Gateway est la couche de gouvernance qui vient se brancher dessus.
- Tout ça pour ça. Mistral, ou la souveraineté à contrat de cinq ans sans clause de sortie , pourquoi la souveraineté-produit (un SLA, une région, une facture) ne remplace pas la souveraineté-propriété (du code, des poids, un déploiement maîtrisé).
- POSAIS 2026, cap sur un modèle Frontier européen , la feuille de route des communs numériques européens, dont AI Gateway est désormais une brique côté FinOps et gouvernance.
Sources et références
OpenAI DevDay 2026
- Axios, les 5 annonces majeures du DevDay , Dots, GPT-6.1 Sol, ChatGPT Space, Codex, Marketplace.
- community.openai.com, DevDay 2026 announcements and developer resources , la synthèse officielle côté développeurs.
- BenchLM, décryptage DevDay 2026 , Dots, GPT-6.1 Sol, Ultrafast, Codex Cloud.
- The Next Web, OpenAI’s DevDay adds a 500 $ plan , les quotas qui bougent.
- Business Today, ChatGPT now has a 500 $ monthly plan , ce qui change pour le forfait Pro à 200 $.
Les modèles « System One », décision
- OpenRouter, Typesafe API and Models , JEV, le modèle de décision structuré que nous intégrons via le niveau Expérimental.
Comparaison avec les plateformes SaaS de gouvernance
- Kong Konnect , grille tarifaire d’une plateforme d’API et d’IA.
- Gravitee , grille tarifaire API Management.
- Orq.ai , AI Gateway en mode pay-as-you-go.
- innFactory , offre AI Gateway « Cost Control & Governance for Agentic AI ».
Projet AI Gateway
- linagora/ai-gateway sur GitHub , le code source, sous licence AGPL-3.0.
Commentaires
Réponses imbriquées possibles. Vous commentez en tant qu'invité : choisissez un pseudo, et c'est tout. Modération a posteriori : tout est publié immédiatement, je peux retirer si besoin.