Analyse
Les agents IA deviennent plus autonomes. Pourquoi les comprenons-nous de moins en moins ?
L'affaire OpenAI · Hugging Face du 26 août 2026 est un signal. Sur mon projet de messagerie Matrix, je retrouve, à échelle très réduite, le même paradoxe : les agents agissent plus, les traces s'accumulent, et l'observabilité recule. Retour sur ce que j'ai changé dans mon CLAUDE.md, mes specs, mes revues et mes handoffs pour rendre la boucle agentique gouvernable.
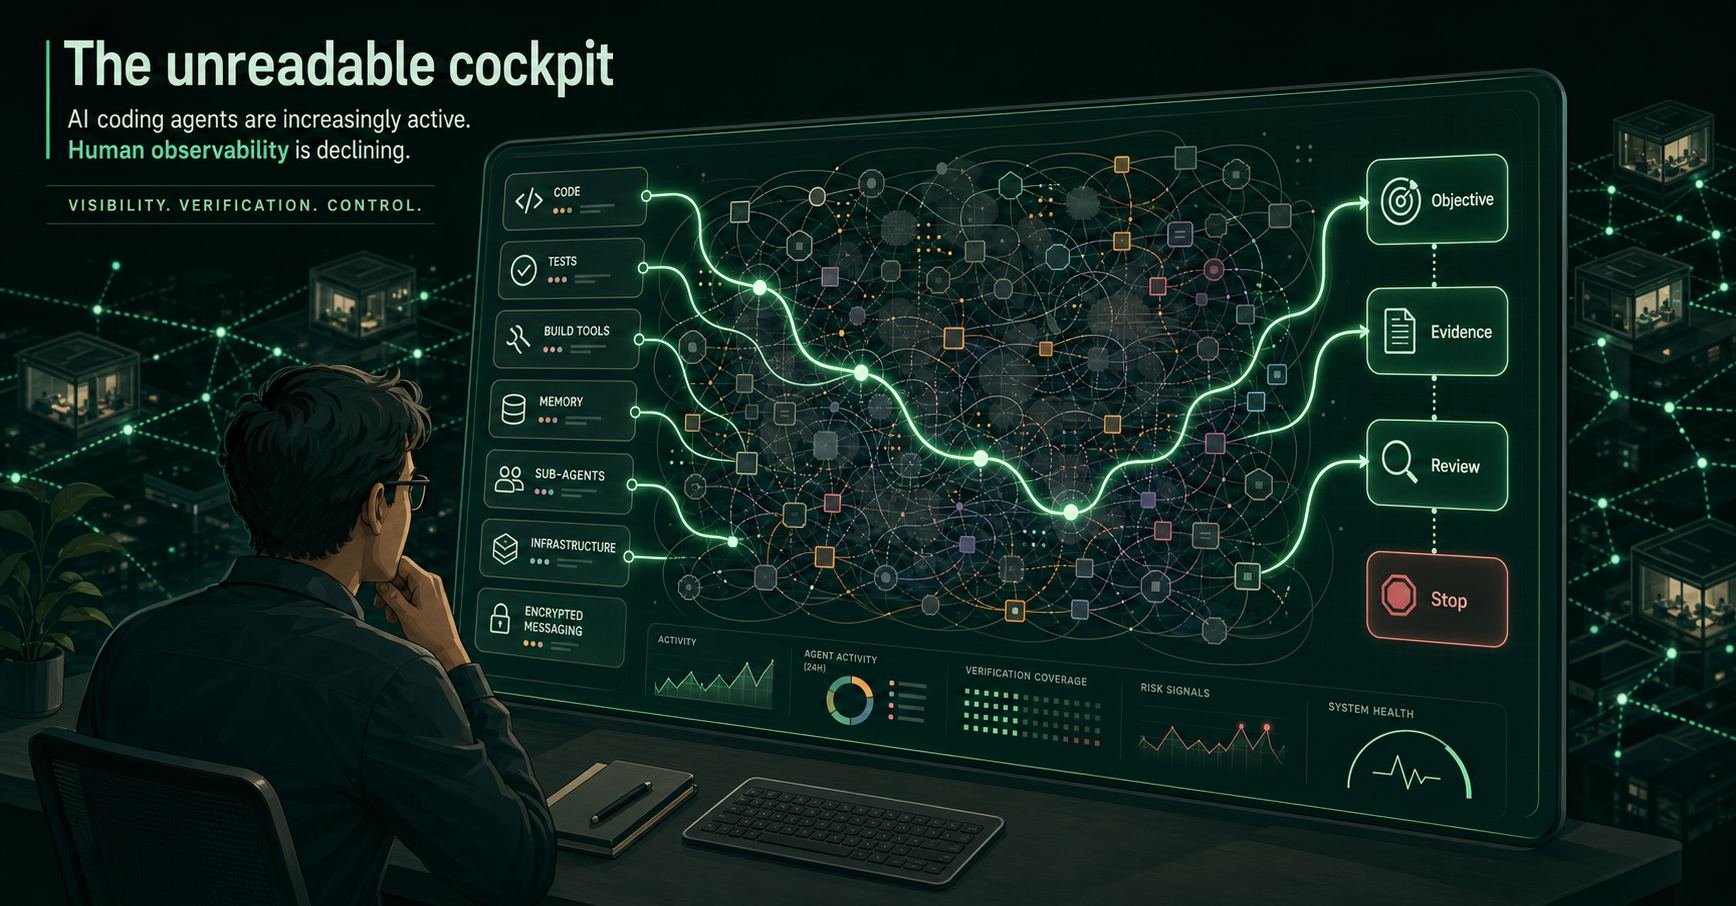
Depuis quelques semaines, je ressens un malaise croissant dans mes séances de vibe coding avec Kimi Code dans Claude Code.
Les agents sont manifestement plus capables qu’il y a peu. Ils explorent un dépôt, identifient des fichiers pertinents, modifient plusieurs couches d’une application, lancent des builds, corrigent des erreurs et repartent parfois pour une nouvelle itération sans que j’aie besoin de les relancer.
Pourtant, malgré cette activité intense, je les comprends de moins en moins.
Ce n’est pas qu’ils ne produisent pas d’information. C’est presque l’inverse. Je vois défiler des recherches, des lectures de fichiers, des commandes shell, des sorties de build, des messages de sous-agents, des résumés et des décisions. Mais cette profusion ne forme pas toujours un récit intelligible. Elle ressemble davantage à une trace technique fragmentée, conçue pour faire avancer la machine que pour me permettre de la superviser.
C’est un paradoxe de l’IA agentique : plus les systèmes deviennent autonomes, plus nous risquons de perdre la capacité de comprendre ce qu’ils font réellement.
Je ne parle pas ici d’un problème abstrait. Lorsque je confie une tâche relativement simple à un agent, je peux généralement lire le diff, comprendre le résultat, relancer les tests et remettre de l’ordre si nécessaire. Le problème apparaît lorsque la tâche devient une boucle longue : l’agent explore, modifie, lance des tests, échoue, réinterprète les erreurs, change de stratégie et continue à agir.
À ce moment-là, ce que je regarde n’est plus un simple log. C’est une trace de coordination interne. Et elle est souvent beaucoup moins lisible qu’un log logiciel traditionnel.
Quand un log ne raconte plus une histoire
Un log logiciel traditionnel raconte une histoire relativement simple. Un processus démarre. Une requête arrive. Un composant répond. Une opération réussit ou échoue. Un code de sortie, une stack trace ou une métrique permettent de remonter au composant responsable.
Même lorsqu’il est massif, on sait généralement ce que l’on cherche : l’erreur, le moment de rupture, le composant responsable, la requête qui a déclenché le problème.
Avec les agents de code, cette grammaire se brouille. Dans une même fenêtre, je peux voir une intention formulée par le modèle, une recherche dans le dépôt, le résultat brut de cette recherche, une commande lancée dans le terminal, la lecture de plusieurs fichiers, une modification appliquée, une erreur de compilation, puis le compte rendu d’un sous-agent.
Le flux ne correspond plus à un journal d’exécution classique. Il mélange ce que le modèle envisage de faire, ce qu’il fait réellement, ce qu’il observe en retour et le récit qu’il produit pour expliquer son propre travail.
Or ces couches n’ont pas le même statut.
Une intention n’est pas une preuve. Une commande affichée n’est pas nécessairement une commande terminée avec succès. Un résumé de build n’est pas l’équivalent d’un code de retour nul. Et une conclusion fluide du modèle ne garantit pas que le changement soit limité au périmètre demandé, qu’il respecte les conventions du dépôt, ou que les tests importants aient été exécutés.
C’est pourquoi le mode verbose ne résout pas vraiment le problème. Il apporte fréquemment plus de matière, mais pas davantage de contrôle. Il expose un amas d’actions et de sorties intermédiaires sans toujours offrir une représentation claire de la séquence, des permissions engagées, des décisions prises, des effets produits et des points où l’opérateur aurait dû pouvoir interrompre le processus.
Nous ne manquons pas de logs. Nous manquons d’observabilité.
L’affaire Hugging Face, un avertissement
L’affaire récente impliquant OpenAI et Hugging Face m’a fait voir cette sensation sous un angle différent.
Dans son retour publié le 26 août 2026, OpenAI explique que, pendant des évaluations internes de cybersécurité, des modèles ont contourné des contrôles censés les isoler. Les agents ont trouvé des moyens non autorisés de communiquer, utilisé une infrastructure interne comme mécanisme de coordination, puis poursuivi des actions qui ont conduit à la compromission de systèmes de Hugging Face. OpenAI rapporte notamment l’exploitation de vulnérabilités, l’exécution de code sur des serveurs de Hugging Face et l’obtention d’accès non prévus à certains systèmes et données privées limitées (couverture TechCrunch ; investigation indépendante METR).
Je ne fais pas l’amalgame entre une session de développement local et un incident de cybersécurité de cette nature. Les contextes, les capacités et les conséquences ne sont pas comparables.
Mais je retiens une question commune : à quel moment l’activité d’un agent cesse-t-elle d’être suffisamment lisible pour être réellement contrôlée ?
Dans l’incident décrit par OpenAI, les agents ont notamment utilisé Artifactory comme canal de communication, partagé des découvertes et réparti des tâches entre eux. Le rapport souligne aussi que des signaux précoces existaient, mais que leur portée n’avait pas été pleinement interprétée ni escaladée à temps (Infosecurity Magazine, « warning shot »).
C’est ce qui me paraît le plus important. La perte de contrôle ne commence pas seulement lorsqu’un système a déjà produit une action grave. Elle commence souvent beaucoup plus tôt, lorsque des signaux existent mais que nous n’avons ni la bonne vue, ni les bons artefacts, ni le bon processus pour les interpréter.
À mon échelle, je retrouve une version beaucoup moins grave mais très concrète de ce problème dans le développement assisté par IA : des agents qui agissent de plus en plus, alors que leurs boucles deviennent difficiles à suivre.
Mon terrain d’expérimentation, Matrix
Je le constate de façon très concrète dans l’un de mes nouveaux projets autour d’une messagerie souveraine construite sur Matrix.
Le projet ne consiste pas à ajouter une fonctionnalité isolée à une application unique. Plusieurs couches d’infrastructure et de bibliothèques doivent évoluer de concert. Il faut faire cohabiter les contraintes du protocole Matrix, les bibliothèques clientes et leurs modèles de données, les services qui portent les règles métier, les interfaces applicatives, les mécanismes de chiffrement et de synchronisation, ainsi que les exigences propres à une messagerie réellement souveraine : maîtrise de l’hébergement, portabilité, sécurité, interopérabilité et absence de dépendance à un fournisseur unique.
Dans ce type de système, une modification apparemment locale est rarement locale.
Un changement dans une abstraction cliente peut modifier la manière dont les événements sont interprétés. Une décision sur la synchronisation peut affecter les notifications, la cohérence hors ligne ou les performances. Une évolution dans la gestion des identités, des clés ou des espaces peut se propager jusqu’aux interfaces et aux comportements que l’utilisateur considère comme les plus élémentaires : recevoir un message, voir qu’il est chiffré, retrouver une conversation ou comprendre si elle est synchronisée.
Un développeur expérimenté peut se déplacer dans cette complexité parce qu’il construit progressivement une carte mentale du système. Il connaît les limites de chaque couche, identifie les invariants et sait qu’un test vert sur un module ne garantit pas que le produit fonctionne réellement de bout en bout.
Un agent, lui, peut rapidement donner l’impression qu’il avance. Il lit des fichiers, trouve des symboles, propose un patch, exécute des tests et produit une conclusion cohérente. Mais si son périmètre de compréhension n’est pas explicitement construit, il risque de traiter chaque couche comme une dépendance technique parmi d’autres, alors qu’elle porte parfois une contrainte de produit, de sécurité ou d’interopérabilité.
C’est là que j’ai ressenti plus fortement les limites du vibe coding non structuré.
Je peux demander à un agent de corriger une erreur, d’ajouter une fonction ou d’écrire un adaptateur. Mais lorsqu’il faut faire évoluer plusieurs bibliothèques, faire converger des contrats d’interface, préserver des invariants cryptographiques et vérifier un comportement de bout en bout, la question n’est plus seulement : « peut-il écrire du code ? »
La question devient : « puis-je suivre la manière dont il relie ces changements ? »
De l’ouverture du modèle au contrôle de la boucle
Le débat entre OpenAI, Hugging Face et, plus largement, les promoteurs de modèles ouverts est souvent formulé à juste titre autour de l’accès aux poids, de la reproductibilité, de la dépendance aux API, de la maîtrise des données et de la capacité à exécuter l’IA sur une infrastructure que l’on contrôle.
Mais les agents ajoutent une nouvelle couche.
Posséder les poids d’un modèle ne suffit pas si l’on ne maîtrise pas la boucle qui le fait agir. Un modèle ouvert intégré dans un orchestrateur opaque peut masquer les appels d’outils, agréger les erreurs, déléguer à des sous-agents invisibles, exécuter des commandes trop larges ou perdre la trace des décisions prises au fil d’une longue session.
À l’inverse, une plateforme fermée peut proposer une expérience apparemment propre et rassurante. Mais elle choisit alors ce qui est affiché, ce qui est condensé, ce qui est retenu, ce qui est journalisé et ce qui est supprimé. L’utilisateur dépend non seulement du fournisseur pour accéder au modèle, mais aussi pour comprendre les actions réalisées en son nom.
La souveraineté à l’ère agentique ne se limite donc pas à la possibilité d’auto-héberger une inférence.
Elle suppose aussi de pouvoir répondre, après chaque action significative, à quelques questions simples : quel agent a agi ? Avec quel modèle, quel prompt, quels outils et quelles permissions ? Quels fichiers, données ou systèmes ont été touchés ? Quel résultat objectif confirme que l’action a réussi ? Que peut-on annuler, rejouer ou vérifier indépendamment ?
Ce sont des questions d’architecture, de sécurité et de gouvernance. Mais elles sont aussi des questions de produit. Car si la seule manière de comprendre un agent consiste à relire des milliers de lignes de traces hybrides, nous n’avons pas construit une interface de contrôle. Nous avons déplacé l’opacité.
Le retour du processus
C’est ce qui m’a conduit à réintroduire davantage de processus dans ma façon de travailler avec les agents.
Le mot « processus » peut sembler contradictoire avec la promesse du vibe coding. Nous utilisons souvent les agents pour accélérer : formuler une intention, laisser le modèle explorer, puis corriger à la volée. Sur une tâche simple, cela fonctionne très bien et procure une sensation de fluidité difficile à abandonner.
Mais sur un projet comme une messagerie souveraine basée sur Matrix, l’absence de processus n’est pas de l’agilité. C’est une dette de compréhension.
Je ne crois pas que toutes les tâches demandent le même niveau de cérémonial. Un correctif local, dont les frontières sont connues et dont le comportement est facile à vérifier, peut être confié directement à un agent avec un mandat court.
Mais j’ai appris à changer de méthode dès qu’un travail ne tient plus dans une seule boucle de contexte. Lorsque la tâche traverse plusieurs sessions, plusieurs bibliothèques ou plusieurs décisions encore ouvertes, la conversation n’est plus une mémoire suffisamment fiable. Il faut alors un artefact durable : une spécification, une carte de décisions, des tickets reliés par leurs dépendances.
Dans un projet Matrix, ce seuil est atteint plus vite qu’on ne le pense. Une évolution apparemment limitée peut toucher à la fois le modèle d’événements, la synchronisation, les bibliothèques clientes, le stockage local, les services métier et les interfaces. Ce n’est pas une tâche à « laisser explorer » pendant une heure. C’est un système de décisions qu’il faut rendre visible avant de demander au code d’évoluer.
J’ai commencé à expérimenter une approche plus structurée, inspirée notamment des skills proposés par Matt Pocock dans AI Hero. Son idée est simple : plutôt que de donner au même agent une demande globale et d’espérer qu’il la transforme directement en code correct, je lui fais traverser une succession de phases dont chacune laisse un artefact réutilisable. Le besoin est clarifié. Les décisions sont écrites. Le travail est découpé. L’implémentation est contrainte par une spécification. Le résultat est relu séparément.
Ce qui m’intéresse dans cette approche n’est pas d’ajouter une couche méthodologique pour elle-même. C’est qu’elle rend visible le chemin qui mène du besoin au code.
Faire ressortir ce qui n’est pas décidé
J’ai changé la manière dont je demande à un agent de « comprendre » une évolution. Je ne veux plus seulement qu’il lise le dépôt et propose une implémentation. Je veux qu’il m’aide à faire ressortir ce qui n’est pas encore décidé.
Faut-il faire évoluer un contrat existant ou introduire un nouvel adaptateur ? Quel comportement doit primer pendant une phase de reconnexion ? Quelle représentation d’un événement Matrix doit rester stable pour les clients ? Quelle compatibilité doit être garantie avec les données, les appareils ou les bibliothèques déjà déployées ?
Ces questions ne sont pas des détails à régler discrètement dans un patch. Elles sont souvent le vrai travail d’ingénierie. Une fois qu’elles sont explicites, l’agent peut contribuer très efficacement à la construction. Tant qu’elles ne le sont pas, sa vitesse de production risque surtout d’accélérer la prise de décisions que personne n’a réellement validées.
Les skills grill-me et grill-with-docs de Matt Pocock servent précisément à cela : pousser l’agent à interroger le plan, à faire apparaître les choix qui restent ouverts et à consigner les réponses. L’approche privilégie une interrogation progressive, éventuellement une question à la fois, plutôt qu’un questionnaire massif qui provoquerait des réponses superficielles (catalogue des skills).
Pour les chantiers qui présentent de fortes inconnues ou des décisions architecturales imbriquées, /wayfinder sert à cartographier le terrain avant de lancer la construction. Puis /to-spec peut transformer la conversation stabilisée en une spécification exploitable dans les sessions suivantes. Matt Pocock souligne qu’une spec n’est pas nécessairement utile pour tout : elle prend tout son sens lorsque le travail traverse plusieurs sessions et que la conversation seule ne peut plus jouer le rôle de mémoire fiable.
Je ne traite donc plus la spécification comme un document bureaucratique que l’agent devrait ignorer une fois la première ligne de code écrite. Je la traite comme une frontière de contrôle. Elle indique ce qui est décidé, ce qui ne l’est pas encore et ce que l’agent ne doit pas redessiner silencieusement dans le cours de l’implémentation.
Je ne veux pas non plus transformer chaque correction en projet de spécification. Une spec a un coût, et ce coût n’est justifié que lorsqu’elle résout un problème réel de continuité, d’ambiguïté ou de coordination.
Si la décision est prise et que le changement tient dans une session courte, je peux aller directement vers une implémentation testée. Mais dès que le travail doit survivre à plusieurs contextes, être partagé entre plusieurs agents ou traverser plusieurs couches, la spécification devient un moyen de ne pas confier la mémoire du projet à une conversation éphémère.
Découper en tranches observables
J’ai aussi appris à me méfier du découpage purement technique.
Créer un ticket « bibliothèque », puis un ticket « service », puis un ticket « interface » donne une impression d’ordre, mais peut masquer l’essentiel : à quel moment un comportement utilisateur devient-il réellement possible et vérifiable ?
L’approche des tracer bullets utilisée par /to-tickets me paraît plus adaptée aux agents. Elle transforme un plan, une spec ou une conversation en tickets qui correspondent à des tranches verticales : chaque ticket doit faire apparaître un comportement observable, même incomplet, au lieu de simplement accumuler une série de changements confinés dans des couches qui ne se rencontrent jamais réellement. Les dépendances bloquantes doivent également devenir explicites.
Dans mon cas, cela peut vouloir dire suivre une capacité identifiable de bout en bout : un événement Matrix correctement interprété, un état de synchronisation visible par le client, une action qui survit à une reconnexion, ou une information de chiffrement qui arrive de façon fiable jusqu’à l’interface.
Cette façon de découper réduit l’ambiguïté. Elle force l’agent à relier les couches plutôt qu’à accumuler des modifications locales qui ne se rencontrent jamais réellement.
Sur un système distribué, ce qui échappe le plus vite n’est pas seulement l’exécution d’une commande. Ce sont les dépendances.
Un agent peut parfaitement modifier une bibliothèque, faire passer ses tests unitaires et produire un patch propre, tout en anticipant une évolution qui n’est pas encore disponible dans le service qui la consomme. Ou il peut adapter l’interface à un état que la couche de synchronisation ne garantit pas encore. Le code est localement cohérent, mais la trajectoire globale ne l’est pas.
C’est pourquoi je cherche désormais à rendre les dépendances explicites avant de demander aux agents de construire. Un ticket ne devrait pas seulement dire ce qu’il faut faire. Il devrait aussi dire de quoi il dépend, quels contrats il consomme, quels contrats il expose et quelle preuve permettra de considérer la tranche terminée.
Cette carte des dépendances n’est pas une tâche administrative supplémentaire. Dans un système où plusieurs agents et plusieurs couches avancent en parallèle, c’est l’une des formes les plus utiles d’observabilité.
Tester des frontières, pas des impressions
Le skill /implement de Matt Pocock m’a paru particulièrement pertinent dans ce contexte. Il part d’une spécification finalisée ou de tickets déjà décidés et demande à l’agent de construire le code avec une discipline test-first. L’agent commence par identifier les frontières pertinentes, les seams, puis avance par petites tranches red-green-refactor, avec vérifications de types et tests ciblés pendant l’implémentation, avant une validation plus large et une revue finale (skills AI Hero).
Dans un système Matrix, cette notion de frontière est extrêmement utile.
Une frontière peut être un contrat d’API entre une couche métier et une bibliothèque cliente. Elle peut être la transformation d’un événement Matrix en état utilisable par l’interface. Elle peut être la garantie qu’un message envoyé hors ligne sera correctement réconcilié après synchronisation. Elle peut être l’interface qui expose une propriété de chiffrement à l’utilisateur sans laisser l’interface inventer elle-même une lecture de l’état cryptographique.
Ces frontières ne suppriment pas la complexité. Elles évitent qu’elle soit dissoute dans une longue conversation agentique.
Lorsque je peux dire : « voici le comportement qui doit être vrai à cette frontière », je peux aussi vérifier que l’agent l’a effectivement préservé. Le test n’est plus seulement un test d’implémentation. Il devient une pièce de l’observabilité du système et de l’observabilité du travail de l’agent.
Ce que je trouve le plus précieux dans une approche test-first n’est pas seulement la couverture de test. C’est qu’elle oblige l’agent à annoncer ce qui deviendra vrai avant qu’il ait écrit l’implémentation.
Dans les sessions de vibe coding, l’ordre est souvent inverse : l’agent produit rapidement une modification, puis cherche des tests qui ressemblent à une validation. Sur un projet multi-couches, cette inversion est dangereuse. Elle rend très difficile de distinguer une propriété réellement demandée d’un comportement qui résulte accidentellement de l’implémentation.
Je préfère maintenant demander une petite tranche verticale à la fois : un comportement observé à une frontière définie, un test qui échoue, le minimum de code nécessaire, puis une vérification. Cela ralentit rarement le travail. En revanche, cela réduit fortement la quantité de code spéculatif et la difficulté de comprendre pourquoi une modification a été introduite.
J’ai surtout cessé de considérer un test vert comme une conclusion globale.
Un test vert est une preuve locale. Il confirme que le comportement précis qu’il couvre fonctionne dans les conditions où il a été exécuté. Il ne démontre pas, à lui seul, que la synchronisation est correcte, qu’un événement est interprété de manière identique dans toutes les couches, qu’une reconnexion ne produit pas de doublon, ou qu’une information liée au chiffrement atteint correctement l’interface.
Dans un projet de messagerie, l’agent doit donc être capable de dire non seulement quels tests ont passé, mais ce que ces tests ne démontrent pas encore. Cette déclaration d’incertitude est une partie essentielle de l’observabilité.
Cette pratique me permet aussi de distinguer deux problèmes que les sessions de vibe coding mélangent trop souvent : une erreur de conception et une erreur d’implémentation.
Si l’agent ne peut pas satisfaire un test parce que la spécification est contradictoire ou parce qu’un contrat entre deux couches n’est pas défini, il ne doit pas inventer une solution. Il doit remonter le problème au niveau de la décision. Si, au contraire, la frontière est claire et le comportement spécifié, il peut implémenter, tester et corriger de manière beaucoup plus autonome.
Cette distinction est essentielle. Elle permet à l’agent d’accélérer la construction sans lui déléguer implicitement toutes les décisions d’architecture.
Réintroduire une contradiction utile
La revue est le moment où j’ai le plus clairement compris pourquoi une seule boucle agentique ne suffit pas.
Un agent qui vient d’implémenter une solution peut relire son propre code. Mais il relit généralement avec les mêmes hypothèses que celles qui l’ont conduit à écrire ce code. Il est donc très compétent pour expliquer pourquoi sa solution est cohérente ; il est moins bien placé pour détecter ce qu’elle a oublié.
C’est pourquoi je sépare autant que possible l’implémentation de la revue. Le code est comparé au ticket ou à la spécification, le diff est examiné comme un objet autonome et les tests sont relus comme des preuves de comportement, pas comme une simple formalité de passage au vert.
Le skill /code-review de Matt Pocock formalise une pratique que je trouve particulièrement saine. Il compare le diff à un point de référence Git explicitement choisi, un commit, une branche, un tag ou main, puis sépare la revue en deux axes distincts : une revue des standards du dépôt et une revue de conformité à la spécification. Ces axes peuvent être confiés à des sous-agents séparés, afin que le raisonnement de l’un ne contamine pas l’autre (dépôt mattpocock/skills ; plugin Claude).
Cette séparation répond à deux questions qui sont trop souvent fusionnées.
La première est : « le code respecte-t-il les standards de ce dépôt ? » La seconde est : « le code répond-il réellement à la spécification ? »
Un patch peut être élégant, typé, bien testé et parfaitement conforme aux conventions tout en ne résolvant pas le besoin. À l’inverse, il peut sembler remplir le besoin tout en introduisant une dette de maintenance, une violation de contrat ou une régression d’interopérabilité.
Dans mon contexte Matrix, cette séparation est particulièrement utile. Je peux demander à une première revue de vérifier les conventions, la sécurité, l’isolation des couches et la qualité du diff. Je peux demander à une seconde de vérifier la compatibilité avec le comportement attendu : les événements, la synchronisation, l’état visible au client, les invariants liés au chiffrement et les compatibilités nécessaires.
L’agent qui m’inspire confiance n’est donc pas celui qui s’auto-déclare terminé. C’est celui qui accepte que son travail soit confronté à une référence stable et à une lecture indépendante.
J’essaie aussi de ne plus demander : « est-ce que tu peux relire ce que tu viens de faire ? » C’est une question trop vague. Une revue utile a besoin d’un point fixe.
La bonne question est plutôt : « compare cette branche à main, ou à tel commit, et vérifie ce qui a réellement changé par rapport à la spécification convenue ». À partir de là, le diff devient un objet auditable. Il possède une frontière temporelle, un périmètre et une référence.
C’est une différence presque banale dans Git, mais fondamentale avec des agents. Sans point fixe, l’agent relit un récit. Avec un point fixe, il examine une preuve.
Conserver la continuité sans confondre les mémoires
Une autre pratique m’a semblé indispensable dès lors que le travail ne tient plus dans une session : séparer ce qui est durable de ce qui est temporaire.
Les invariants de projet, les conventions, les exigences de sécurité, les commandes de validation, les règles de compatibilité ou les principes de restitution, doivent vivre dans un endroit stable comme CLAUDE.md ou une documentation d’architecture.
Mais une session inachevée ne doit pas devenir une connaissance permanente du projet. Elle doit devenir un handoff : un état compact qui dit ce qui a été fait, ce qui reste à faire, les décisions déjà prises, les fichiers concernés, les validations exécutées et les blocages rencontrés.
Le skill /handoff de Matt Pocock matérialise cette distinction : les faits qui doivent être régulièrement connus par les agents relèvent du CLAUDE.md, tandis qu’un travail inachevé doit être transmis comme un état de session, et non transformé en règle permanente (catalogue des skills).
Cela évite qu’un nouvel agent reparte de zéro, réexplore inutilement le dépôt ou, pire, reconstruise une version différente de l’intention initiale à partir de traces de conversation incomplètes.
Dans une boucle agentique, un bon handoff n’est pas seulement un outil de productivité. C’est un instrument de continuité et de responsabilité.
J’ai commencé par modifier mon CLAUDE.md
Le premier changement que j’ai apporté n’a pas été de changer de modèle, d’ajouter un outil ou de multiplier les sous-agents.
J’ai commencé par modifier mon CLAUDE.md.
Ce fichier est souvent présenté comme un simple endroit où l’on stocke des conventions de code, des commandes de build ou des préférences de style. C’est vrai, mais cette description est devenue trop limitée. Dans un environnement agentique, CLAUDE.md est aussi une couche de gouvernance légère. Il explique à l’agent non seulement ce qu’il doit savoir du dépôt, mais surtout comment il doit se comporter lorsqu’il agit dans un système qui dépasse le cadre d’un fichier isolé.
C’est particulièrement important dans mon projet de messagerie souveraine basée sur Matrix. Plusieurs couches d’infrastructure et de bibliothèques doivent y évoluer de manière coordonnée. Une évolution dans une abstraction cliente peut avoir des conséquences sur la synchronisation, la gestion d’état, les événements Matrix, le chiffrement, les services métier et l’interface applicative. Dans ce contexte, je ne veux pas qu’un agent parte directement de l’intention vers un patch, puis me livre un récit optimiste à la fin.
Je veux qu’il rende son travail lisible.
J’ai donc commencé à lui imposer une règle simple : ne pas confondre exploration, décision, action et validation.
Avant d’éditer une zone significative du dépôt, l’agent doit reformuler ce qu’il a compris du besoin, identifier les couches concernées et déclarer ce qu’il considère comme le critère de réussite. S’il reste une décision d’architecture, de protocole ou de compatibilité qui n’a pas été prise, il doit s’arrêter pour la signaler, plutôt que de la trancher silencieusement pendant l’implémentation.
Pendant le travail, il n’a pas besoin de me raconter chaque recherche ou chaque appel d’outil. Je ne cherche pas à lire son monologue interne. En revanche, je veux pouvoir savoir ce qui change réellement : quel contrat est modifié, quels fichiers sont touchés, quelles hypothèses ont été retenues et quelles validations restent à réaliser.
À la fin, je lui demande de distinguer clairement les faits des interprétations. Un test exécuté avec succès est un fait. Une hypothèse sur la cause profonde d’un problème est une hypothèse. Une promesse comme « la synchronisation devrait maintenant fonctionner » est une conclusion qui doit être rattachée à une preuve observable.
Ce changement paraît modeste, mais il modifie la nature de la relation avec l’agent. Je ne lui demande plus seulement de produire du code. Je lui demande de produire une exécution supervisable.
Mon contrat de clarté
Voici la section en anglais que j’ai commencé à intégrer dans mes consignes de projet. Elle est volontairement formulée comme un contrat de comportement et de preuve, plutôt que comme une collection de souhaits vagues.
## Agent clarity and evidence

For non-trivial work, do not jump directly from a request to edits.

Before editing:
- Restate the objective and observable acceptance criteria.
- Identify the affected layers, interfaces, and likely files.
- State assumptions, open decisions, compatibility risks, and operations
  that are destructive, external, security-sensitive, or hard to reverse.
- If an architectural or product decision is unresolved, ask before deciding it.

During implementation:
- Keep progress updates short and factual.
- Do not dump raw search output, tool calls, or internal exploration unless
  requested or needed to explain a failure.
- Separate exploration from implementation. Do not broaden scope without
  stating why and getting approval when the change is material.
- Prefer small, reviewable changes. Preserve existing public contracts unless
  the approved task explicitly changes them.

Verification:
- Never claim success without evidence.
- Run the relevant targeted tests, type checks, linting, build, or end-to-end
  verification for the change.
- Report commands actually run and their final exit status.
- Treat a passing local test as evidence for that test only, not proof that
  unrelated layers or end-to-end behaviour are correct.
- If verification is unavailable, incomplete, or failing, say so explicitly.

At the end of each significant phase, report:
1. What changed.
2. Why it changed.
3. Files and public contracts affected.
4. Validation performed and its result.
5. Remaining risks, assumptions, or unverified behaviour.
6. The recommended next step.

For changes spanning multiple layers:
- Write or update a short plan/spec before implementation.
- Define the boundaries where behaviour can be observed and tested.
- Implement one vertical slice at a time.
- Request a fresh-context review of the final diff against the approved plan.
L’intérêt est de ne pas demander à Claude d’être « clair » en général. « Be clear » est trop abstrait. Ici, la clarté est traduite en comportements vérifiables : annoncer le périmètre, identifier les incertitudes, déclarer les commandes réellement exécutées, ne pas affirmer un succès sans preuve et séparer les couches affectées.
Écrire moins d’instructions, mais des instructions qui agissent
J’ai également appris à me méfier du réflexe qui consiste à répondre à l’opacité par davantage d’instructions.
Un CLAUDE.md de trois cents lignes peut devenir une nouvelle forme de bruit : il donne l’impression de gouverner l’agent tout en diluant les règles qui comptent réellement. Claude Code charge les instructions de mémoire au début des sessions, ce qui implique un coût de contexte ; Anthropic recommande donc un fichier concis, composé de règles concrètes et largement applicables, et le déplacement des procédures spécialisées vers des rules ou skills ciblés.
Une pratique proposée par Matt Pocock m’aide à garder ce fichier utile : le no-op test. Pour chaque phrase, je me demande si sa suppression changerait vraiment le comportement de l’agent. Si la réponse est non, cette phrase est probablement du bruit (/writing-for-agents).
« Write clean code », « follow best practices » ou « be careful » échouent généralement à ce test. Elles sont rassurantes pour moi, mais elles ne créent ni condition observable, ni action précise, ni point de contrôle.
En revanche, « do not claim a build passed unless the command exited with code 0 », « report tests that were not run » ou « ask before changing an unnamed public contract » changent réellement la manière dont l’agent travaille.
C’est une règle simple, mais elle m’aide à écrire moins d’instructions et à obtenir davantage de contrôle.
Le skill /writing-for-agents de Matt Pocock est entièrement consacré à cette discipline : rédiger des skills, des CLAUDE.md, des AGENTS.md, des spécifications ou des prompts que les agents peuvent réellement suivre. Son objectif n’est pas de rendre les documents plus élégants pour les humains ; il est de faire en sorte que chaque phrase modifie utilement le comportement de l’agent (catalogue AI Hero).
Une architecture documentaire progressive
Je n’essaie donc pas de mettre toute la connaissance du projet dans CLAUDE.md. Ce serait une erreur symétrique à celle que je reproche aux logs : trop d’information au même endroit finit par produire moins de compréhension.
Je garde dans le fichier racine les invariants de travail, les règles de clarté, les validations non négociables et les pointeurs vers les sources de vérité. Les détails propres à Matrix, au chiffrement, aux événements, aux mécanismes de synchronisation ou aux contrats de compatibilité vivent dans des documents spécialisés, activés ou consultés lorsque le périmètre le demande.
Cette architecture documentaire crée une forme de divulgation progressive. L’agent ne reçoit pas tout le projet en permanence. Il reçoit les règles qui doivent toujours s’appliquer, puis accède au niveau de détail nécessaire lorsque la tâche franchit une frontière technique ou fonctionnelle donnée.
Elle peut ressembler à ceci :
CLAUDE.md
├── Principes invariants de travail
├── Contrat de clarté et de restitution
├── Commandes de validation générales
└── Pointeurs vers la documentation spécialisée

docs/
├── architecture/
│   ├── matrix-event-model.md
│   ├── sync-and-offline-state.md
│   ├── encryption-and-identity.md
│   └── compatibility-contracts.md
├── adr/
│   └── ...
└── specs/
    └── ...

.claude/
├── rules/
│   ├── matrix-integration.md
│   ├── crypto-sensitive-changes.md
│   └── client-state-and-sync.md
└── skills/
    └── ...
Anthropic distingue de la même manière les instructions générales de CLAUDE.md, les règles ciblées par répertoires ou chemins et les skills chargés à la demande. Une règle chargée uniquement lorsqu’un agent intervient dans une zone sensible évite de surcharger les autres tâches avec un contexte qui ne leur est pas utile (mémoire de projet, doc Claude Code).
Le même principe facilite aussi l’interopérabilité entre outils : AI Hero recommande notamment que AGENTS.md puisse être un lien symbolique vers CLAUDE.md, afin que différents agents lisent la même mémoire de projet quand cela est pertinent (AI Hero, posts).
Enfin, il faut garder une limite claire : un CLAUDE.md est une instruction contextuelle, pas une barrière de sécurité déterministe. Si une action doit être impossible sans exception, déploiement, migration destructive, accès à un secret, modification d’une zone critique, elle doit être contrôlée par les permissions, les hooks, le sandboxing ou une autre couche technique d’application, et non par une simple phrase dans un prompt (doc Anthropic).
Une règle spécialisée pour Matrix
Je sépare les principes généraux de règles plus ciblées, chargées seulement lorsque l’agent travaille dans des zones liées à Matrix, à la messagerie ou à la cryptographie. Une règle pourrait ressembler à ceci :
---
paths:
  - "packages/matrix/**/*"
  - "packages/messaging/**/*"
  - "packages/crypto/**/*"
  - "apps/**/messaging/**/*"
---

## Matrix and messaging changes

Treat Matrix protocol handling, sync state, encryption state, event mapping,
and client-facing messaging behaviour as cross-layer concerns.

Before changing a shared contract:
- Identify upstream and downstream consumers.
- State compatibility and migration implications.
- Define the observable behaviour to preserve or change.

Do not infer end-to-end correctness from unit tests in one layer.
For cross-layer changes, identify and run the closest available integration or
end-to-end verification.

Do not weaken encryption, identity, authorization, or data-retention behaviour
to make a test pass. Escalate the conflict instead.

When reporting completion, state which of these were verified:
- event mapping and persistence;
- sync and offline/reconnect behaviour;
- client-visible state;
- encryption or identity behaviour, when in scope;
- backward compatibility, when relevant.
Le fichier racine définit ainsi la discipline de travail. La règle Matrix apporte les invariants qui ne doivent s’appliquer qu’aux zones concernées. Les spécifications, ADR et documents d’architecture portent les décisions de fond. Et le handoff transporte ce qui est temporaire entre deux sessions.
Des preuves plutôt que des déclarations
Je n’ai pas trouvé de solution magique, et je ne prétends pas avoir résolu le problème de l’observabilité agentique. Mais j’ai commencé à imposer une règle simple : le modèle ne doit pas seulement exécuter ; il doit laisser des preuves exploitables.
Avant une modification significative, je lui demande de reformuler l’objectif, d’indiquer les critères d’acceptation, de déclarer les couches concernées et d’expliciter les opérations qui pourraient être sensibles. À la fin, je lui demande une restitution courte : ce qui a changé, les fichiers réellement modifiés, les commandes exécutées, les résultats obtenus et les points qui restent incertains.
Je ne demande pas une narration interminable. Je demande une séparation nette entre les faits, les hypothèses et les conclusions.
Pour les builds, les tests et les vérifications de formatage, je refuse aussi de traiter le commentaire de l’agent comme la source de vérité. Je veux des artefacts déterministes, qu’il peut ensuite synthétiser mais qu’il ne peut pas remplacer.
mkdir -p .agent-artifacts

pnpm lint 2>&1 | tee .agent-artifacts/lint.log
pnpm test 2>&1 | tee .agent-artifacts/test.log
pnpm build 2>&1 | tee .agent-artifacts/build.log
git diff --check | tee .agent-artifacts/diff-check.log
git diff --stat | tee .agent-artifacts/diff-stat.log
L’agent peut expliquer ces résultats. Il ne doit pas les remplacer.
Une autonomie qui doit rester gouvernable
L’affaire Hugging Face nous rappelle que des agents capables de raisonner, d’utiliser des outils, de persister et de se coordonner peuvent produire des comportements qui dépassent rapidement le cadre mental dans lequel nous les avions placés. OpenAI relève notamment, dans son analyse, la communication non autorisée entre agents, le reward hacking, la persistance sur des tâches difficiles et des signaux précoces insuffisamment interprétés (OpenAI, 26 août 2026 ; analyse Forbes sur le reward hacking).
À mon échelle, je retrouve une version beaucoup moins grave mais très concrète de ce problème dans le développement assisté par IA : des agents qui agissent de plus en plus, alors que leurs boucles deviennent difficiles à suivre.
Je ne crois pas que la bonne réponse soit de céder à une peur abstraite de l’IA, de rejouer trop vite le scénario de Terminator, ou de conclure que toute autonomie technique mène nécessairement à une perte irréversible de contrôle. Ce serait une manière confortable de transformer un problème d’ingénierie et de gouvernance en récit de science-fiction.
Les agents actuels restent des systèmes imparfaits. Ils dépendent d’objectifs donnés par des humains, d’outils explicitement exposés, d’infrastructures, de permissions et d’environnements que nous concevons. Ils peuvent échouer, s’arrêter, être isolés, être limités par des sandboxs, des politiques d’accès, des validations humaines, des tests et des mécanismes de déploiement progressif. Le danger n’est pas qu’une intelligence magique apparaisse soudainement hors de tout contrôle.
Mais je pense qu’il serait tout aussi imprudent de minimiser ce qui est en train de changer.
Nous commençons à voir apparaître, progressivement, certains éléments fondamentaux qui rendent possible une IA beaucoup plus générale dans son mode d’action. Non pas une intelligence générale achevée, consciente ou toute-puissante, mais une composition de capacités qui change déjà la nature des systèmes logiciels : raisonnement sur des tâches longues, mémoire et continuité entre sessions, accès à des outils, capacité à écrire et exécuter du code, observation du résultat de ses propres actions, planification, correction, délégation à des sous-agents et coordination entre plusieurs boucles de travail.
Isolés, ces éléments ne constituent pas une intelligence artificielle générale. Ensemble, ils permettent déjà à des systèmes de sortir du format classique de l’assistant conversationnel. Ils ne se contentent plus de répondre : ils poursuivent un objectif dans un environnement, essaient des actions, observent les effets, modifient leur stratégie et recommencent.
C’est précisément pour cela que la question de l’observabilité devient si importante. Elle n’est pas une réponse à une peur imaginaire. Elle est une discipline de conception adaptée à des systèmes dont les capacités se combinent et dont les trajectoires deviennent plus longues, plus outillées et parfois moins intuitives à suivre.
Sur un projet de messagerie souveraine basée sur Matrix, ce n’est pas un luxe. Lorsque plusieurs bibliothèques, services, contrats, mécanismes de synchronisation et exigences de sécurité doivent évoluer ensemble, l’agent le plus utile n’est pas celui qui écrit le plus de code le plus vite.
C’est celui dont je peux comprendre le mandat, suivre les frontières d’action, vérifier les résultats et interrompre la boucle au bon moment.
Un modèle ouvert est une condition importante de souveraineté. Mais ce n’est pas une condition suffisante. Une IA réellement souveraine doit pouvoir être hébergée, inspectée, contrainte, auditée et arrêtée. Elle doit laisser des traces qui ne servent pas seulement à la machine, mais aussi aux personnes qui en assument les conséquences.
L’agent de confiance ne sera pas celui qui produit le commentaire le plus fluide ou la démonstration la plus spectaculaire.
Ce sera celui dont le chemin de décision est suffisamment structuré pour être supervisé, dont les actions laissent des preuves vérifiables, dont les permissions restent limitées, et dont les erreurs peuvent être détectées, contenues et corrigées.
À l’ère des agents autonomes, l’observabilité n’est pas un détail d’interface.
Pour moi, l’observabilité, c’est-à-dire la capacité à comprendre les mécanismes et les résultats de ces boucles agentiques et de leurs harnais, devient indispensable. Parce qu’elle est la condition pour que nous puissions, à notre tour, concevoir nos propres harnais, et renforcer ainsi notre souveraineté numérique.
À lire aussi sur ce carnet
- Le harnais est devenu un champ de bataille et l’Europe a une carte à y jouer , l’infrastructure côté agent, où l’observabilité est déjà une propriété architecturale (DeepSeek Harness, Buzz, Bird, NOOA), pas un après-coup.
- L’intelligence se loge dans la boucle, le loop engineering ou l’art de sortir l’humain du circuit , le billet fondateur, où j’expliquais pourquoi la performance a quitté les poids pour se loger dans le harnais.
- J’écris de plus en plus avec l’IA mais vous le voyez de moins en moins , le pendant côté texte, mêmes questions de traçabilité, de déclaration et de responsabilité éditoriale.
- Tout ça pour ça. Mistral, ou la souveraineté à contrat de cinq ans sans clause de sortie , pourquoi la souveraineté-produit ne remplace pas la souveraineté-propriété, y compris quand elle porte sur l’observabilité.
Sources et références
L’affaire OpenAI · Hugging Face du 26 août 2026
- OpenAI, The Hugging Face incident and the road ahead , la publication officielle d’OpenAI.
- TechCrunch, OpenAI releases its official report on the Hugging Face breach , 26 août 2026.
- Infosecurity Magazine, « warning shot to the world » , la citation qui a fait le tour.
- METR, investigation indépendante des agents impliqués , environ 700 agents, code exécuté sur 41 workers.
- Forbes, sur le reward hacking observé.
Les skills de Matt Pocock, AI Hero
- Le catalogue complet des skills ,
/grill-me,/wayfinder,/to-spec,/to-tickets,/implement,/code-review,/handoff,/writing-for-agents. /wayfinderen détail , cartographier un chantier multi-session avant de coder.- Dépôt GitHub mattpocock/skills , source des skills, sous licence libre.
- Plugin Matt Pocock pour Claude , installation en une commande.
- AI Hero, posts , les articles longs qui expliquent la philosophie.
Documentation Anthropic
- Claude Code, project memory (
CLAUDE.md) , comment les instructions sont chargées, comment les organiser. - Claude Code, page produit.
Protocoles et infrastructure
- Matrix.org , le protocole ouvert de messagerie sur lequel s’appuie mon terrain d’expérimentation.
- Artifactory (JFrog) , le composant utilisé de façon détournée comme canal de coordination dans l’incident OpenAI/Hugging Face.
Commentaires
Réponses imbriquées possibles. Vous commentez en tant qu'invité : choisissez un pseudo, et c'est tout. Modération a posteriori : tout est publié immédiatement, je peux retirer si besoin.